go on this: https://axi404.top/blog/eai-papers#%E6%9C%BA%E5%99%A8%E4%BA%BA%E6%95%B0%E6%8D%AE%E9%9B%86
ImageWAM (109)
️️⭐️️⭐️⭐️ Wenyao Zhang, Xiaokang Yang, SJTU | https://www.alphaxiv.org/abs/2606.19531
- 动机:也许不需要 VM,只需要 edit.
- 方法:
- MoT 架构不变,换为 FLUX.2 4B (flow-matching),编辑目标是 16 帧以后的观测图像,进行监督,推理时仅前向一次干净图像.
- 结果:
- 真机 demo 是 pick and place,精度和流畅度不错
- 点数挺高, robotwin c2c r2r ~93%
RL-token (110)
⭐⭐️️⭐️️⭐️️️️ Charles Xu, PI |https://www.alphaxiv.org/abs/2604.23073
- 动机:想通过小 RL 提升动作 precision 和 speed,但是 DSRL 能调节的局限性又太强.
- 方法:VLA 输出额外 token,第一阶段用它重建 VLA 输入. 第二阶段冻结 VLA 和提取器,训练 actor critic,这俩都会接收 RL token. actor 还额外接收 VLA 给出的参考动作块&带正则化防偏离,critic 则接收待评估动作块. 给人工标注的成功/失败奖励即可.
- 结果:成功率和 DSRL 差不多,但是 RLT 更快.
ActionCodec (111)
⭐⭐⭐ Zibin Dong, Jianye Hao| https://www.alphaxiv.org/abs/2602.15397
一种 RVQ 设计,注重以下指标:“相邻动作片段的 token 更稳定、减少不必要的 token 数量、让 token 更好地对应图像和指令,以及减少 token 之间的依赖”
RVQ 直出 action 执行,比 pi05-style 的 KI 点数高 1%. no demo.
Deepseek V41 Flash (112)
- CED: decoder 后 20 层直接用第 20 层的 hidden state.
- CSA2: CSA(用滑动窗口最近原始 token + 历史压缩 token) 改进版
- Single-Pass mHC、Engram 与 DSpark (wtf is this)
- 每 token 的 KV 缓存从 V4 的 3514 bytes 降到 890 bytes.
- 后训练没有变化.
Phoenix-MWA (113)
⭐⭐⭐ 无界动力(北京) | https://openphoenix-team.github.io/Phoenix-pages/
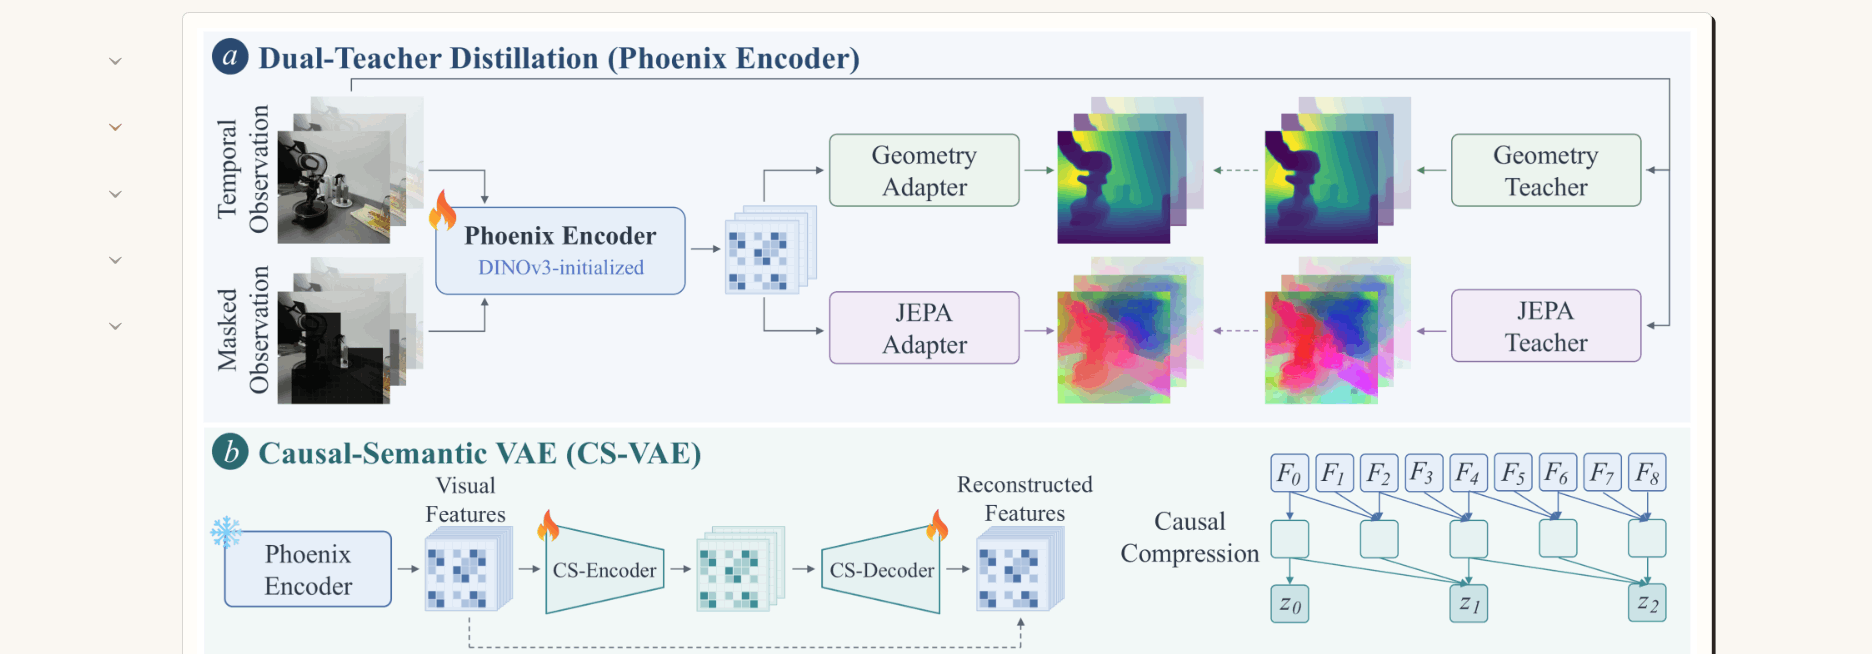
其编码器蒸馏了深度和 JEPA,然后用它额外训了一个 VAE,与 WAN-VAE 在 channel 上 concat.l
另外,sampler 直接使用了 intern-w0 的.
Wave Forcing (114)
⭐⭐⭐ yijie jin, zhijie deng, SJTU DENG Lab | https://sjtu-deng-lab.github.io/WaveForcing/
Video DiT 推理加速 2.5x
- 4 GPU 对 4 个 chunk 同时流式去噪逐步推进时间步,就是把 rolling forcing 的 bi attn 改为 causal attn.
- 1GPU 做 kv cache filling
- 3GPU 做 VAE pipeline. 三阶段训练 mixednoise-init + 分布匹配蒸馏 DMD + self-generated history DMD
BEYOND VALIDATION LOSS (115)
⭐⭐ zhanyi sun , shuran song | https://www.alphaxiv.org/abs/2611.01565
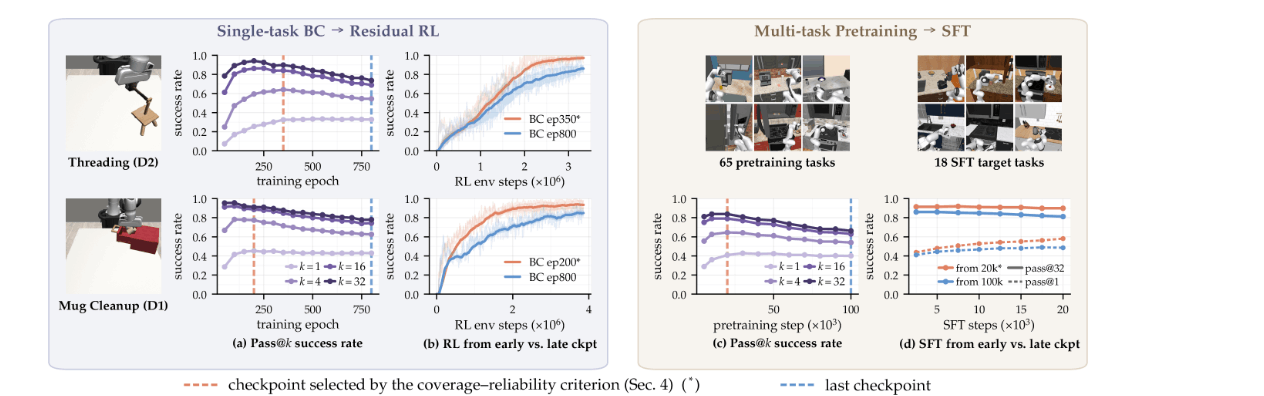
本文发现 dp & pi05 在 mimicgen 和 robocasa 上,训多了以后 pass@1 提升单 pass@k 下降,并认为其反映了动作分布下降。于是提出不是使用动作 val loss 而是用多次生成的误差分为数来判断训练终止… 并提出使用生成模型(U-Net 图像和 DiT 动作)提升动作覆盖.
R²-WAM (116)
⭐⭐ Kai Liu, He, Wang 中科大 北大 | https://www.alphaxiv.org/abs/2610.13024v1
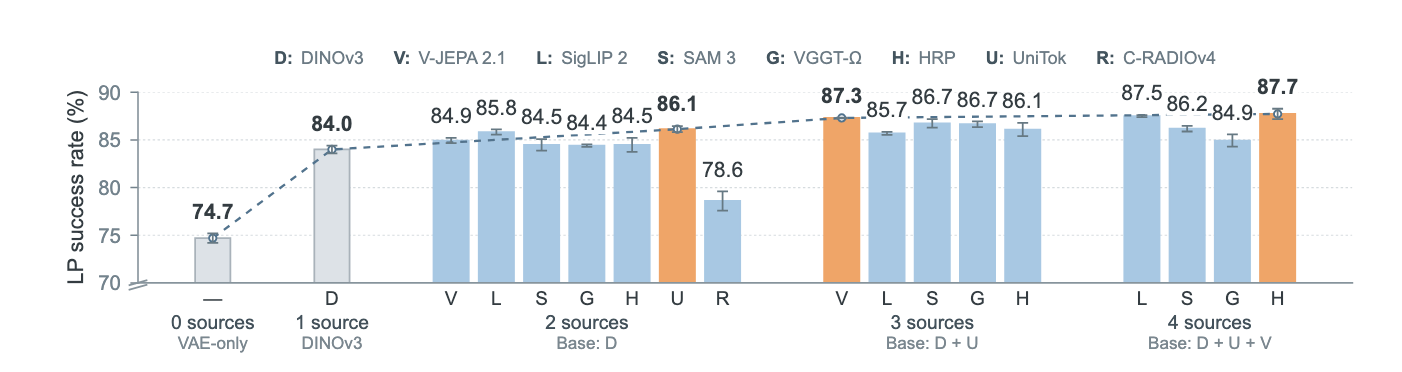
系统比较了 Liberoplus 上,用哪几种特征组合最好,所有 source 通过拼接加入…
- DINOv3 + unitok + v-jepa2.1 + HRP 最高(每个高0.4~2.1)
- 通道拼接比 token 拼接和特征专家好