RynnVLA-Latent (101)
⭐⭐⭐️ 达摩院 | https://www.alphaxiv.org/abs/2610.34356
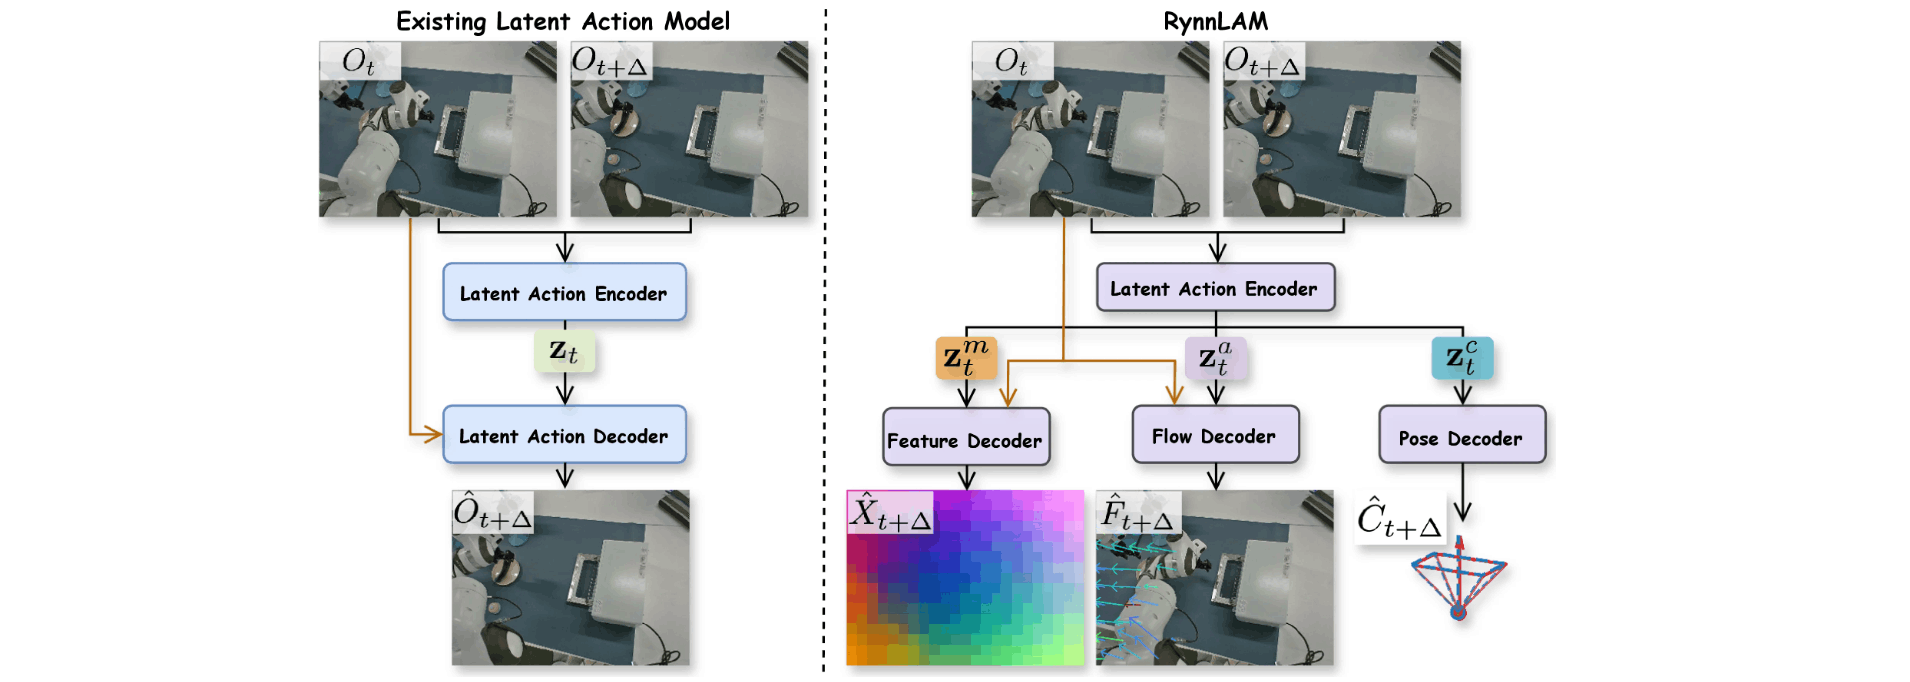
LAPA style,但是监督了残差(Depth Anything 3 两帧直接相减) + 3D Flow + 相机位姿. 处理了 3w 小时 robot, ego & sim 数据.
灵巧仿真 & 夹爪真机上 demo 还可以.
VLA-Delta (102)
⭐ Qi Lu, Xuhong Zhang, OmniAI, ZJU | https://www.alphaxiv.org/pdf/2610.21306
加了光流、结构化、difference text 监督… Qwen backbone… 调参大师来了…
整个网站、文章和图都非常 vibe.
ATM (103)
👍 Chuan wen, pieter abbeel | https://www.alphaxiv.org/abs/2401.00025
早期一种利用无标签数据的方式. 让一个 transformer 预测二维点轨迹,再训练一个 ViT 风格的下游策略,输入二维轨迹 & img 输出动作.
训练时随机撒点筛选动静大的点作为预测目标,推理时由于无法预知哪些点动静大,故 4x8 均匀撒点后预测. 这是因为作者认为 Track Transformer 本身具备置换不变性(Permutation Invariance).
Contact Trajectory Prompting (104)
👍 xian nie, shuicheng yan, TARS | https://www.alphaxiv.org/abs/2610.18848
BPP 的触觉版本. VAE 训练一个动作和触觉编码器 (token decode 还原动作和触觉),然后每对数据是用同一任务里另一 episode[1] 的触觉数据来 prompting 接下来的动作
- 考虑推理 ICL 不是让你复制这个触觉对应的动作,所以需要另一 episode,和 BPP 一致.
TacForesight (105)
👍 xian nie, wenchao ding, TARS | https://www.alphaxiv.org/pdf/2606.11184
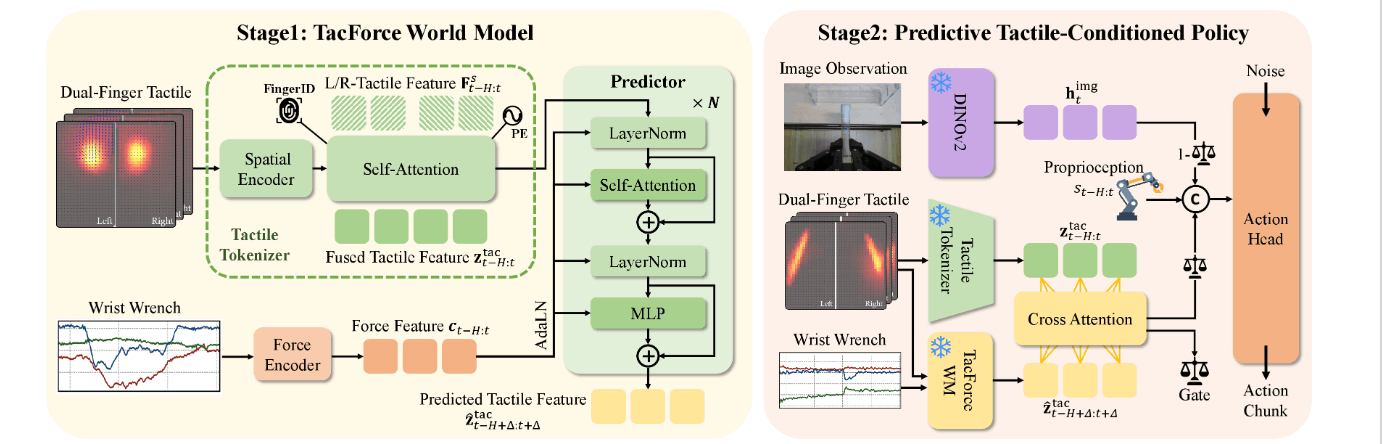
动机:力触一起输入的话,触觉信号会有 200ms 这样一个延迟,不如预测触觉. 方法:
- Xense 千觉视触觉传感器.
- tactile encoder
- tactile WM 中编码历史帧 tactile 以后,在历史 force condition 下预测未来 tac feature. 参数量 11.8M.(不是这怎么感觉有点欠约束)
- 在 policy 中当前 tactile feature 去 cross-attend WM 给出的未来 tactile feature 作为 policy 条件. 下游是小 policy; 结果:demo 擦花瓶,刷卡和拧瓶盖,速度慢但是准度还可以,抗光照和手持扰动.
CR-Dagger (106)
⭐⭐⭐️ xiaomeng xu, shuran song, Stanford | https://www.alphaxiv.org/abs/2506.16685
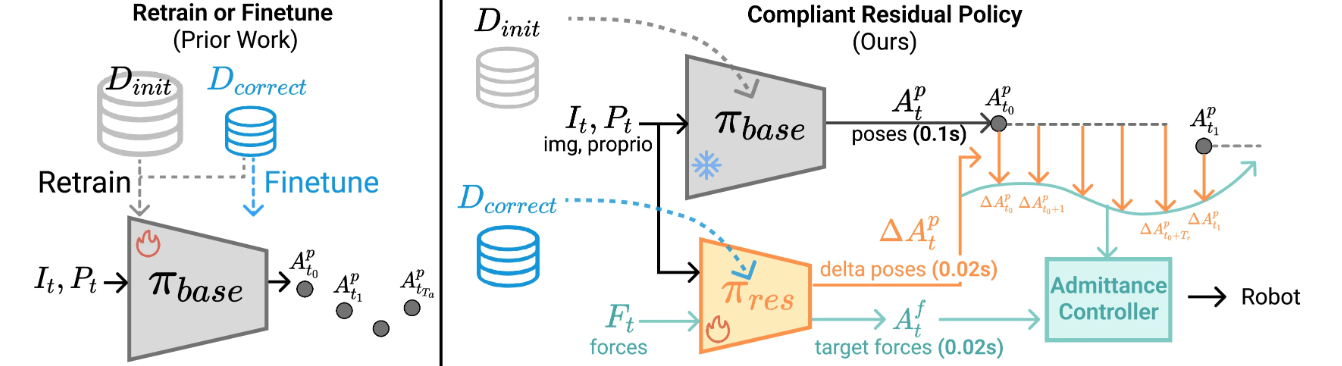
早就看过了,明确一些细节.
- 动机:解决 contact-rich 任务传统人工 dagger 不平滑的问题.
- 方法:
- 机械臂带力反馈。rollout dagger 时人类轻轻把机械臂往正确方向推.
- 此时机械臂并不是因为受力直接被推开,而是根据一个虚拟弹簧公式改变位控目标,同时记录位置差值和末端收到的外力.
- 训练 residual policy,输入和原始一样,输出位置差和目标外力.
- rollout 预测 delta 和期望外力,用导纳控制(如果目标力大于真实力,则贴得更紧)
- 结果:翻书、皮带装配、齿轮插入和线缆布设.
OmniVTA (107)
⭐⭐⭐ Yuhang Zhang, Wenchao Ding, NUS 新加坡国立 & TARS | https://www.alphaxiv.org/abs/2603.19201
- 方法:
- 本文构建了一个 20k traj 的触觉数据集 OmniViTac.
- cascaded 架构:wm 预测未来 vis & tac 然后送给 adaptive policy(根据预测的接触概率调整 vis & tac 权重)
DexPort (108)
⭐⭐⭐⭐ Amber Xie, Haozhi Qi, Amazon FAR | https://www.alphaxiv.org/pdf/2610.32969
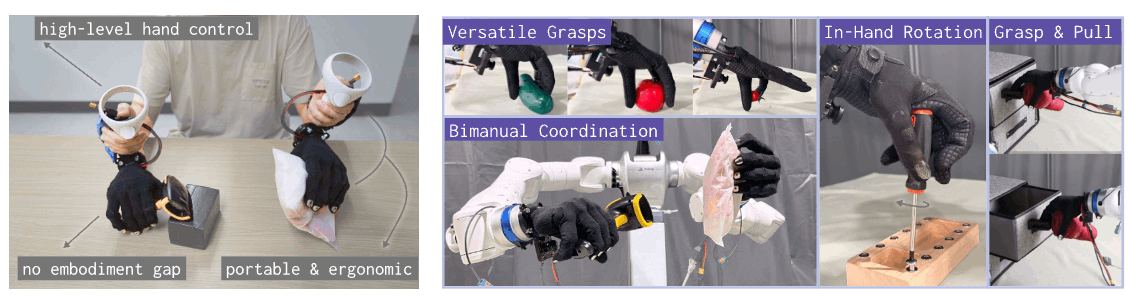
- 动机:想要采训硬件一致,但是又想降低 dex 手搓压力,故用更低自由度的 Quest 2 控制器和 primitive.
- 方法:
- 通过 quest2 的按钮切换拇指移动/抓握/捏取等 primitive,其上的摇杆调节弯曲/捏取程度(两个自由度),直控 WUJI Hand.
- 训练 policy 依然是全自由度动作,但是用 command 而非 state(报告了 state 合不紧问题).
- 用的 DINO-DP.
- 结果:
- action label 用 command/state 成功率 64%/11%.
- 有一个小的预训练 (in-the-wild 0/500/1000) 表明预训练有助于 seen obj/unseen obj/干扰物场景的成功率.
- 估计也是挺费劲.
堆积如山
- PhysCanvas
- AW-0