时间预算非常不够,大概读一下,只看 idea.
Dream1 (91)
https://dreamlabs.ai/research/dream-1/
没有提到架构,只说 eef, 并且认为 WAM 有自动适应本体和头部视角的能力.
其实 demo 拍摄的比较拉,但是我们真机 zero-shot 实测其实还可以.
BOE; BridgeWAM (92)
⭐️⭐️ 方佳鑫, FDU, 椰青分享 | https://www.alphaxiv.org/abs/2610.14746
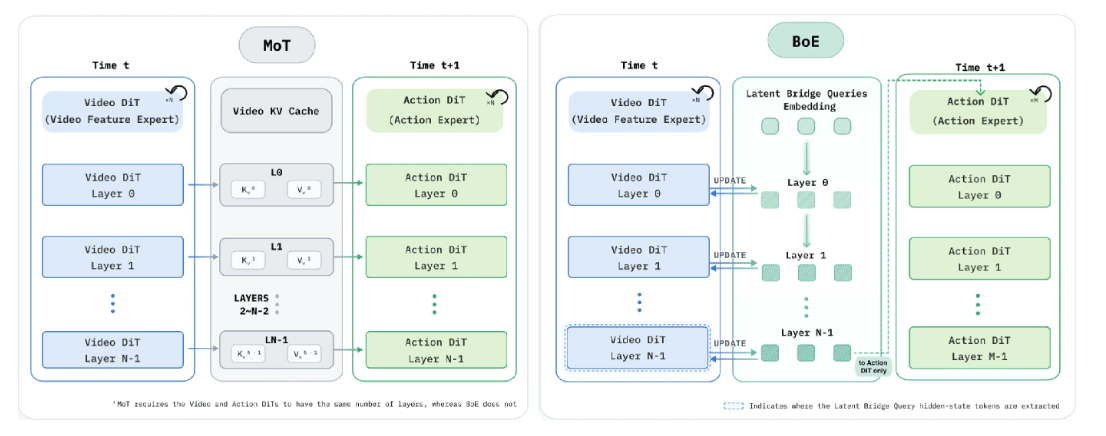
用 learnable query (直接放 video dit) 代替 MoT. ae 只有两层.
主要是为了加速,以及(据称)减少无关视觉干扰. 不过用 VPP 套这个 BoE,作者说掉点了.
ForceWAM (93)
⭐️⭐️⭐️ zijun xu, wendi chen, FDU, SJTU, 杨理欣
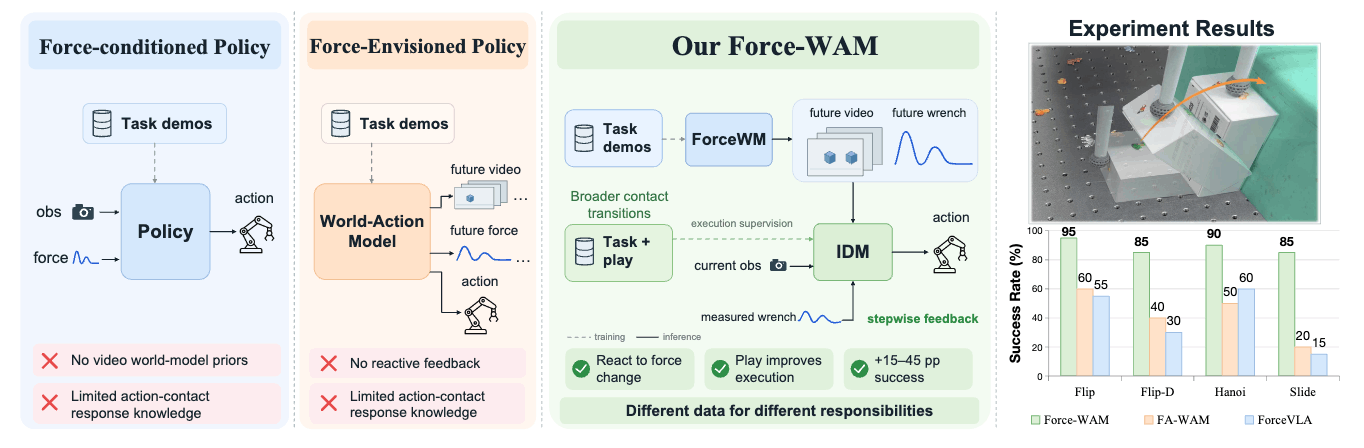
训练一个预测未来六轴力矩的 WM,然后小型 IDM, reactive.
训练数据有 demo & play,其中 play 是探索性按压等非成功操作. Play 数据只用于训练 IDM.
EvoMemVLA (94)
⭐️⭐️ yuheng na, haoang li, XJTU | https://www.alphaxiv.org/pdf/2610.05418
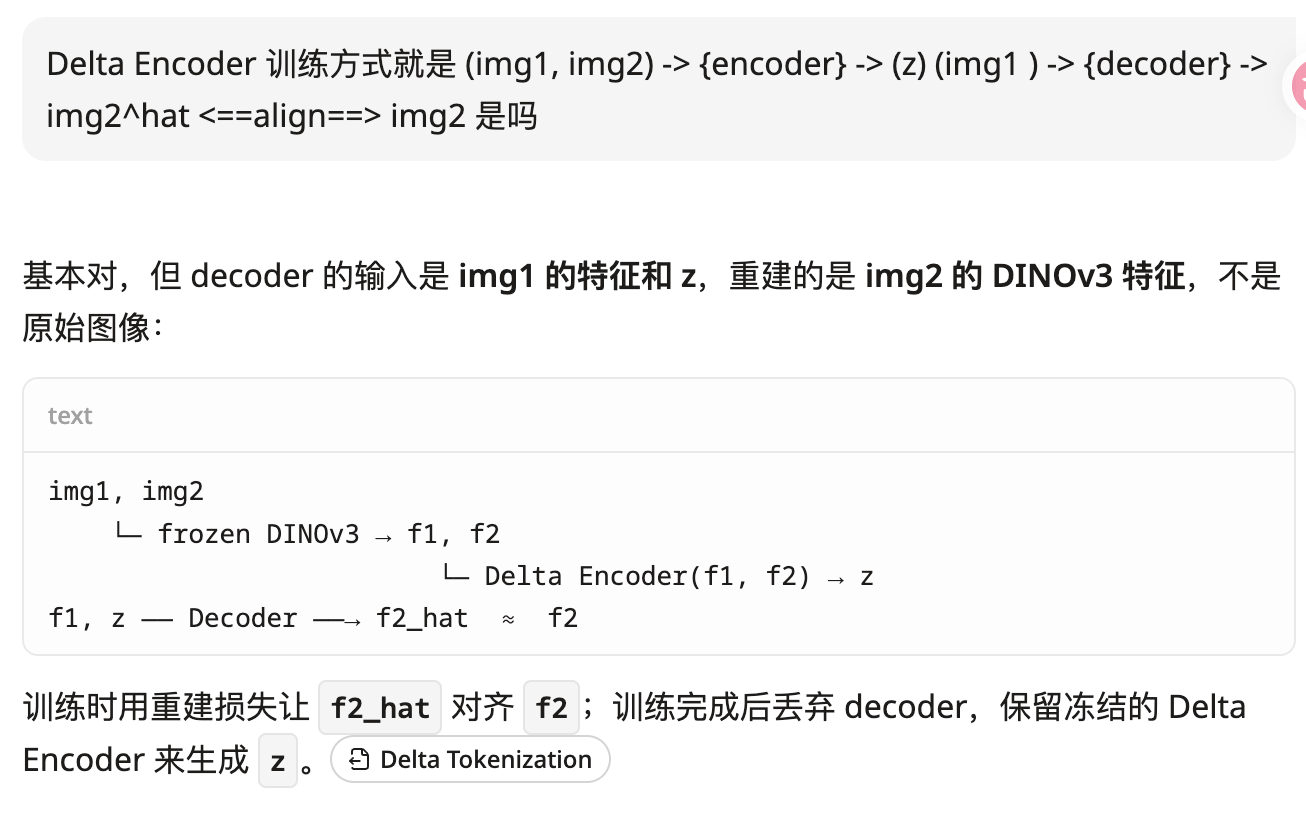
为了增强记忆能力,用 DINOV3 提取图片特征后,训练 LAPA-style 相邻帧隐式动力学 encoder,插入 state 历史中送入 VLM.
RMBench 上移除 delta tokens(仍保留视觉历史帧和子任务路由),整体成功率从 80.7% 降到 52.3%;改用简单的 DINOv3 特征相减则为 47.1%
SuperMimic (95)
⭐️⭐️⭐️⭐️⭐️ qiayuan liao, UCB | https://www.alphaxiv.org/abs/2610.28480
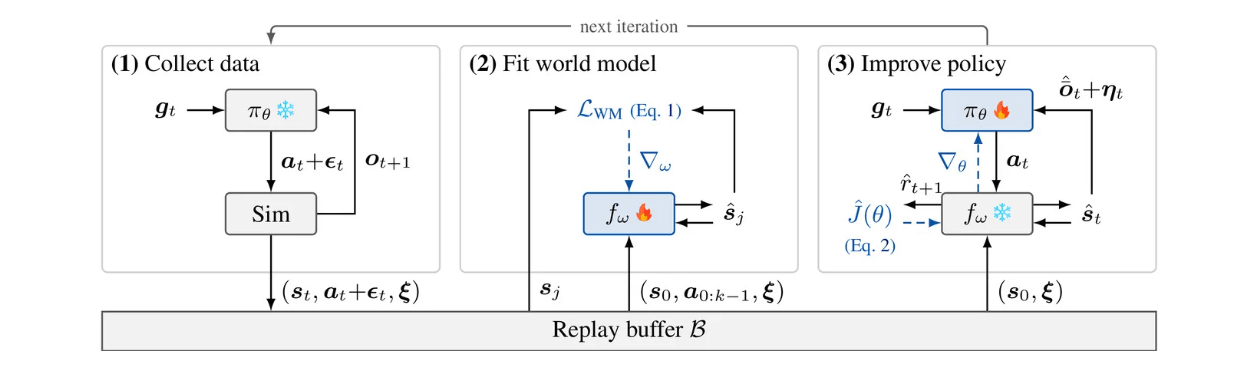
引入 WM 加速 rollout 10 倍,通过 32 步 wm imagine 将 policy 训练时样本效率提升 64 倍.
wm 只预测 1 步,因此并不 conditioned on policy. 而要进行多步预测的话,就要 wm -> policy -> wm -> policy… 这样去 roll.
- 训练 WM 时,8 步窗口,直接从 replay buffer 中取 (s, a),自回归预测 s_hat, loss 直接取 s_hat <=> s>
-
- 训练 policy 时,32 步窗口,冻结 WM:
-
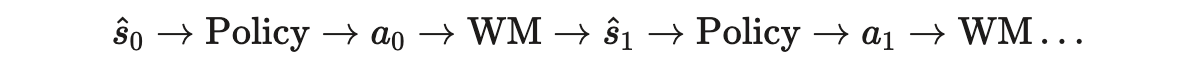
- 通过 BPTT 反传梯度.
-
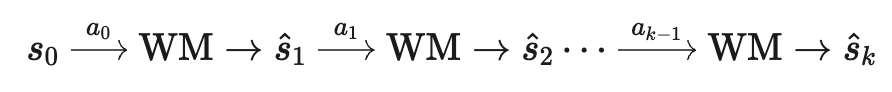
flowchart LR
    S["当前状态 s_t"] --> D["动力学 MLP<br/>2048 → 2048 → 2048"]
    A["动作 a_t"] --> D
    X["仿真上下文 ξ"] --> D
    D --> NS["下一状态 ŝ_(t+1)"]

    NS -.-> R["奖励预测头. 非 learnable 但可微"]
    NS -.-> O["无噪声观测预测头"]
    NS -.-> T["终止概率预测头"]
    G["目标 g_t"] -.-> R
    G -.-> T
flowchart LR
    G["未来 10 帧参考动作"] --> E["动作编码器 MLP<br/>2048 → 1024 → 512 → 256"]
    E --> Z["32 维潜变量 z"]

    O["最近 10 帧观测历史"] --> D["共享解码器 MLP<br/>2048 → 1024 → 512 → 256"]
    Z --> D
    D --> A["29 维动作<br/>关节设定值"]

    S["状态 s_t、目标 g_t、上下文 ξ"] --> V["Critic MLP<br/>256 → 128"]
    V --> Q["回报估计"]
FOMI (96)
yishu shen, yinghao xu, HKUST 港科大 | 剪刀手 UMI. 没有安装力传感器也没有安装触觉传感器。Why not use generalist?
When One Step Is Enough (97)
⭐️⭐️⭐️ 日本 ARAYA Inc | https://www.alphaxiv.org/abs/2610.30735
拿 SmolVLA、X-VLA、FLOWER、π0.5、LAP 以及 XR-0 这六个模型的官方 ckpt 测试 FM 多步积分和单步积分.
结论是对于 1B 以上并且训练充分的模型,一步和多步基本等价
然而 qwen-manip 中呈现 FM4 和 FM10 在 robotwin c2r (joint) 上有显著差异.
EmbodiedEvo (98)
Einsai.AI(香港, Calvin Xiao) | https://www.alphaxiv.org/abs/2610.18867
智能体先在每类任务的单一演练场景(Playground)中探索,将沉淀的 skills & lessons 固化后直接迁移给新场景中的独立智能体复用. 在依赖记忆的任务和协调动作更有优势.
FLORA (99)
NVIDIA 推出的切分、标注和打分模型 (9B, 17B, 397B-A17B),是三个 Qwen 训练的. 在 WGO-Bench, RoboReward 和 Robometer 取得 SOTA 而成本只有 astra 1/125.
奖励可以标稀疏或者每 0.5s 稠密. 权重已开源.
PrismWAM (100)
⭐️⭐️⭐️ 清华, NVIDIA | https://www.alphaxiv.org/abs/2610.26564
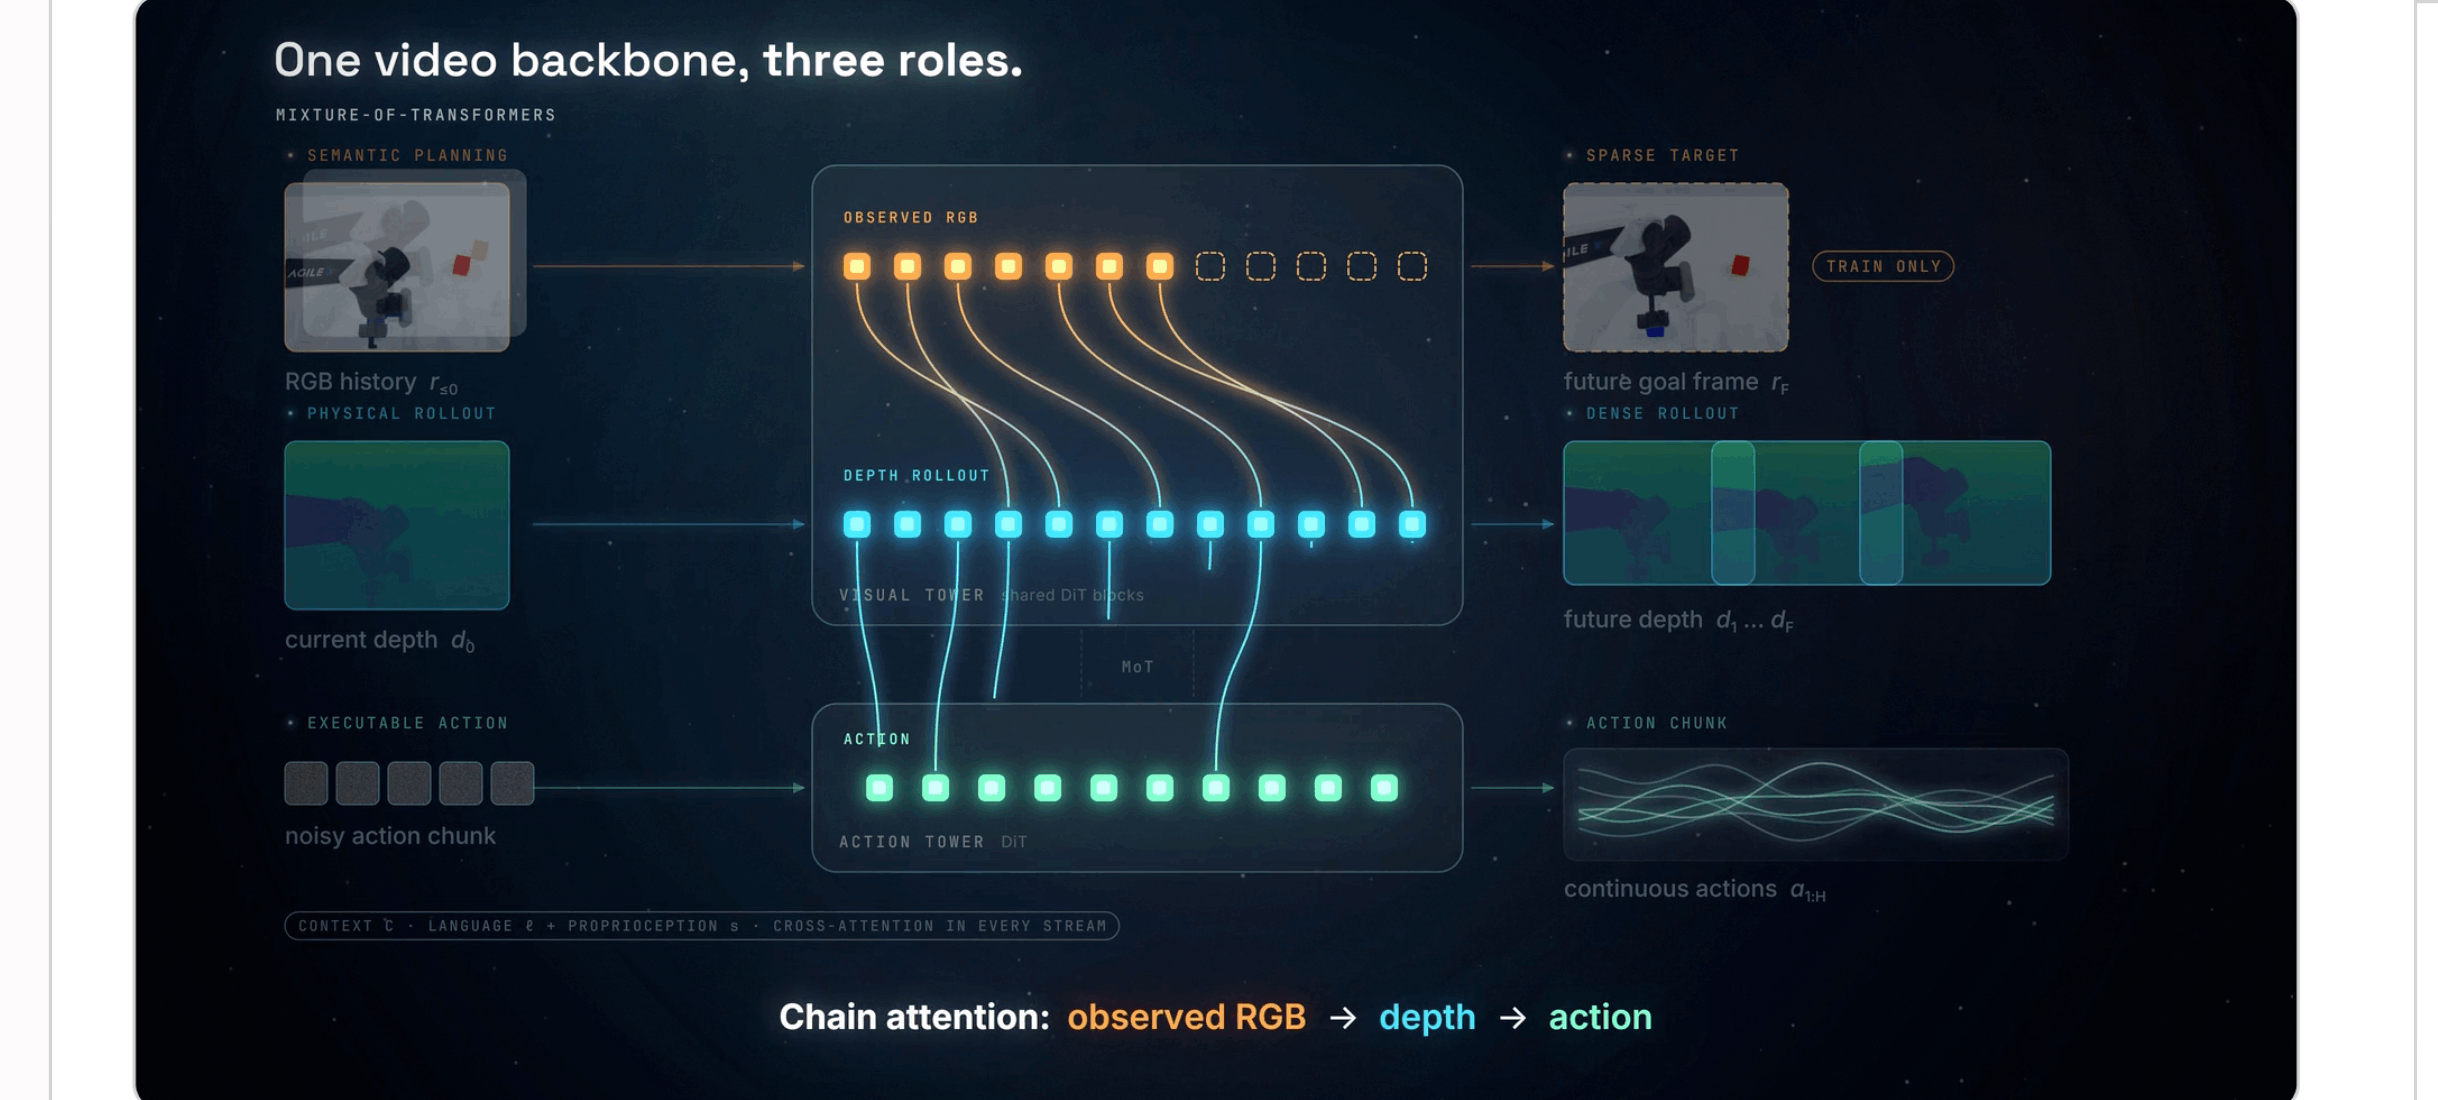
本文考虑到WAM不应该从 rgb 反推动作,应该从深度反推动作. 因此,RGB 仅仅是辅助任务,并且只预测任务完成后的一帧. 两者共享 WAN 主干.
C2R 挺高的,但是这是当然的.