李飞飞的 OpenWAM (75)
⭐️⭐️⭐️⭐️ 通过反事实数据强化 IDM. Heng Yu, Ehsan Adeli; Stanford | https://www.alphaxiv.org/pdf/2610.07922
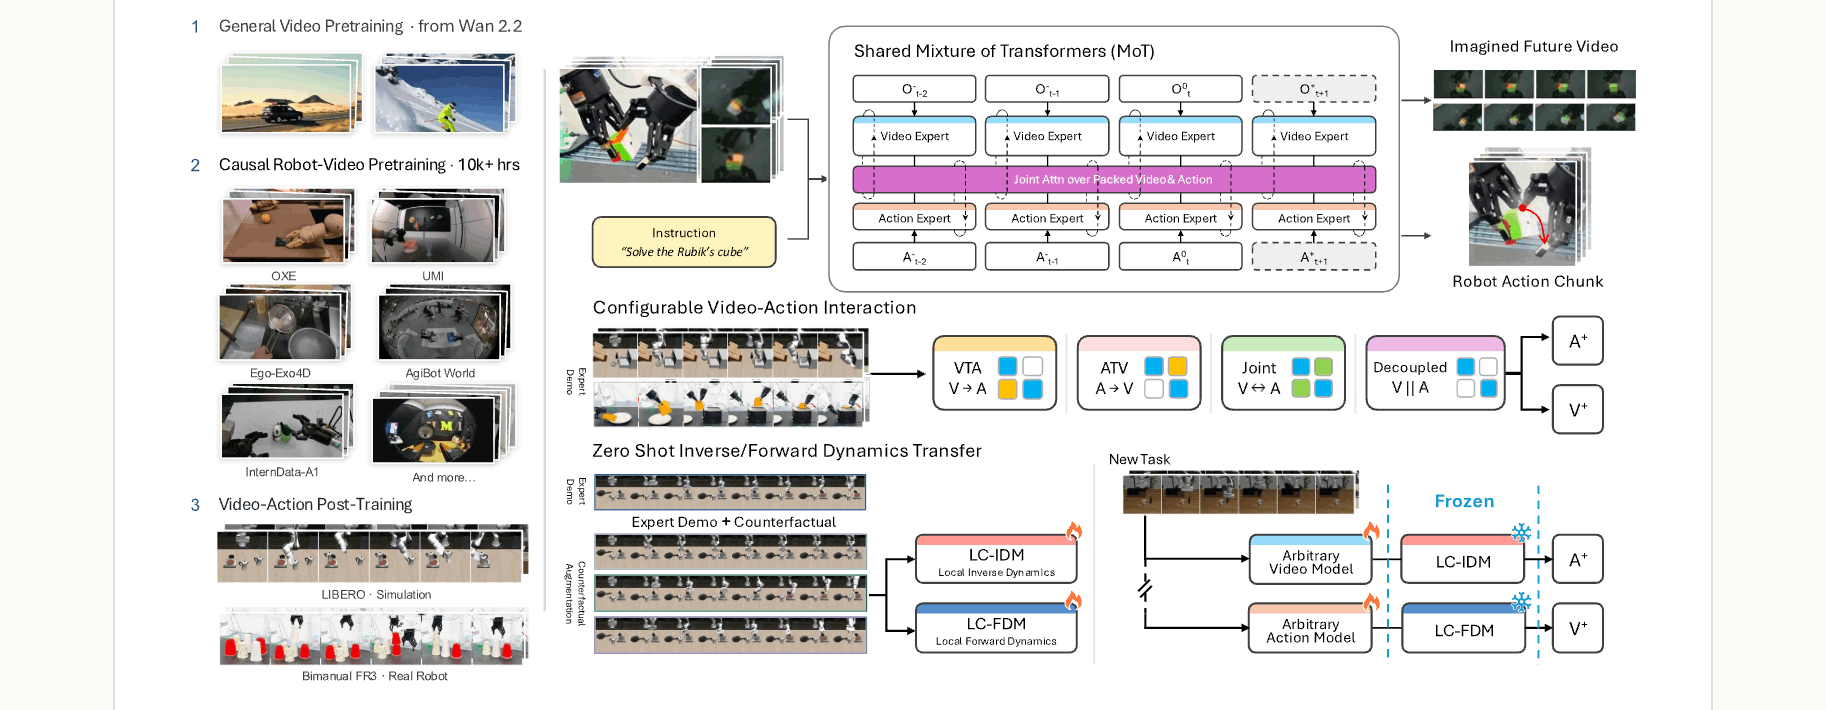
常规架构,各种 ablate. VTA 就是 IDM. ATV 就是 FDM. 其中的反事实数据 counterfactural data 比较 make sense.
- 固定 VTA/Joint 下,机器人视频因果预训练将 LIBERO-Long 成功率从 Wan2.2 的 68.4%/62.2% 提升至 97.8%/96.6%
- 相同预训练与训练设置下,MoT 相比非 MoT 将 VTA/Joint 成功率分别提高 5.0/3.0 个百分点
- 四种交互模式中,VTA 的 LIBERO 平均成功率最高为 98.6% 且 ATV 最低为 96.8%
- 目标任务迁移中,local-context IDM (no history, no text) 加反事实数据(该部分数据仅开启未来画面 -> 未来动作的监督)的平均成功率为 84.0% 而仅用示范为 21.5%
- 混合监督(60% 反事实数据加 40% 示范)下,local-context IDM 目标任务成功率比 full-context IDM 高 37 个百分点且源任务成功率为 94.4%
- Local-context IDM 的反事实单独训练与混合训练迁移表现接近,四任务平均成功率分别为 84.5% 和 84.0%. 注意这里迁移指的是已有对新任务微调过的 WM,仅续训分离式 IDM.
- FDM 加入反事实监督后,RGB MSE 下降 34.5% 且 16 个同状态结果的识别准确率从 21.1% 升至 71.3%
- 单一多目标模型(同时训练策略、IDM 和 FDM)的策略成功率为 92.8% 低于专用策略模型的 97.8% 且其反事实 FDM 误差也高于专用 FDM
Behavior Cloning Mystery (76)
⭐️⭐️⭐️ https://www.alphaxiv.org/abs/2610.07056
这文章是 sergey 之前就发过的 blog. 用一个比较 toy 的 ocbench (state-based resMLP flow bc, 130M 参数) 发现了如下问题:
- 验证集 flow loss 上升时,成功率仍然上升.
- action chunk (开环) 成功率 >> 单步闭环.
- 更复杂的动作 pattern(e.g. 人类的)可能需要更大的网络.
- 即使 dataset 巨大,输入 state 的尺度变化仍会影响成功率.
不是你这怎么主要结论都是 state based 啊,我真无语了,那有啥说服力了。虽然 1/2/3/4 我们早就有实验发现过.
UNITAS (77)
⭐️⭐️⭐️ Ruixiang Wang, 贾奎; 跨维智能&港中深 | https://www.alphaxiv.org/abs/2610.12099
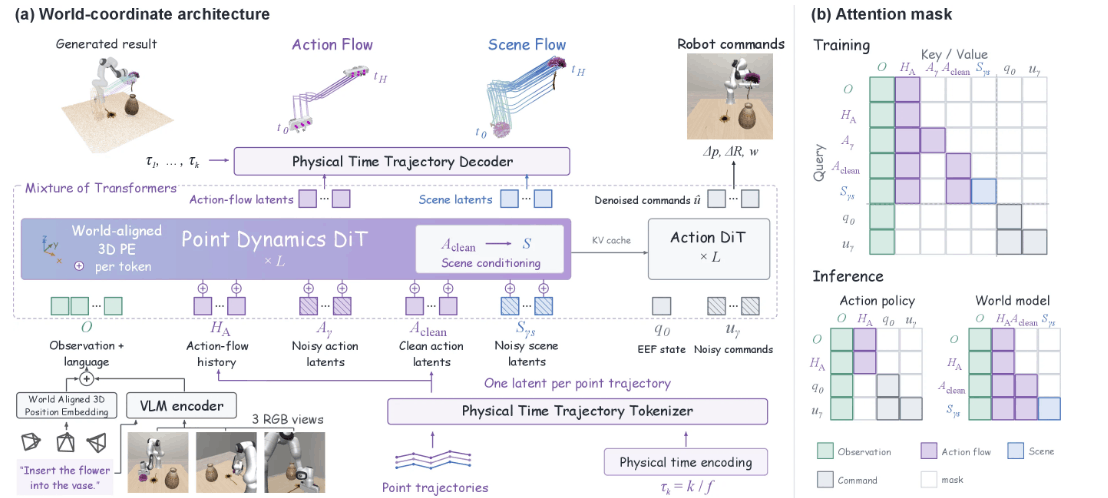
先训练一个将一段轨迹 [T, 3] 编码为 latent 的 enc-dec,然后训练一个 1.7B DiT,输入 VL & action flow history,接 decoder 输出未来 action flow 和 scene flow. 右边 MoT 接一个 AE 输出 action.
点数挺高的。
DiVeR (78) 分歧片段
⭐️⭐️⭐️ Seongheon Park, Yasuyuki Matsushita; 微软 & 威斯康星大学 | https://www.alphaxiv.org/abs/2610.04933
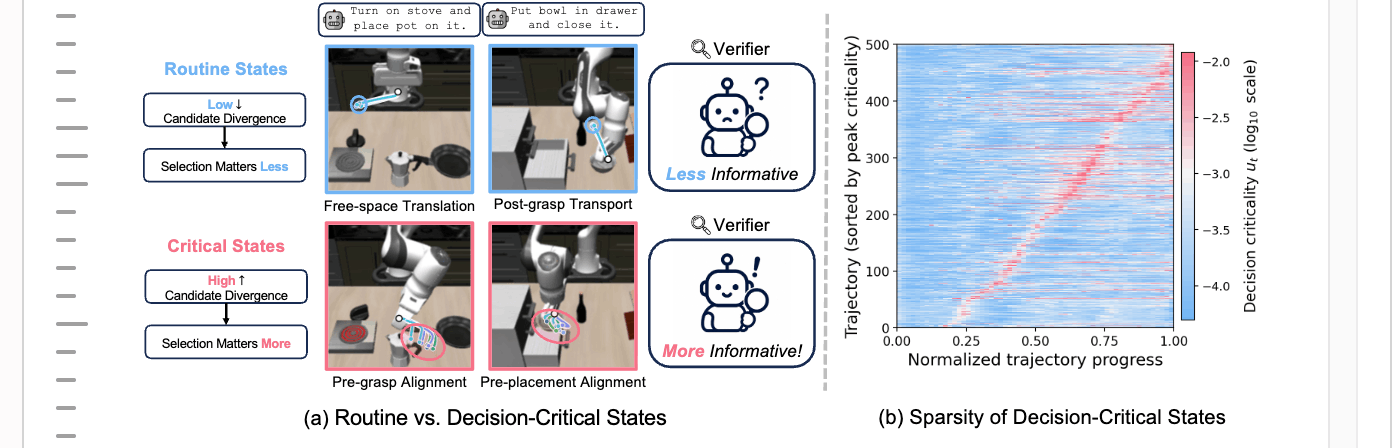
本文发现在 pick and place 任务上,那些分歧程度高的动作片段对于成功率的影响更大. 通过提高分歧程度高的片段的训练权重,可以提升成功率。
基模是 pi0.
SimEX (79)
⭐️⭐️⭐️ Jiaheng Hu; Amazon, UT | https://www.alphaxiv.org/abs/2609.38982
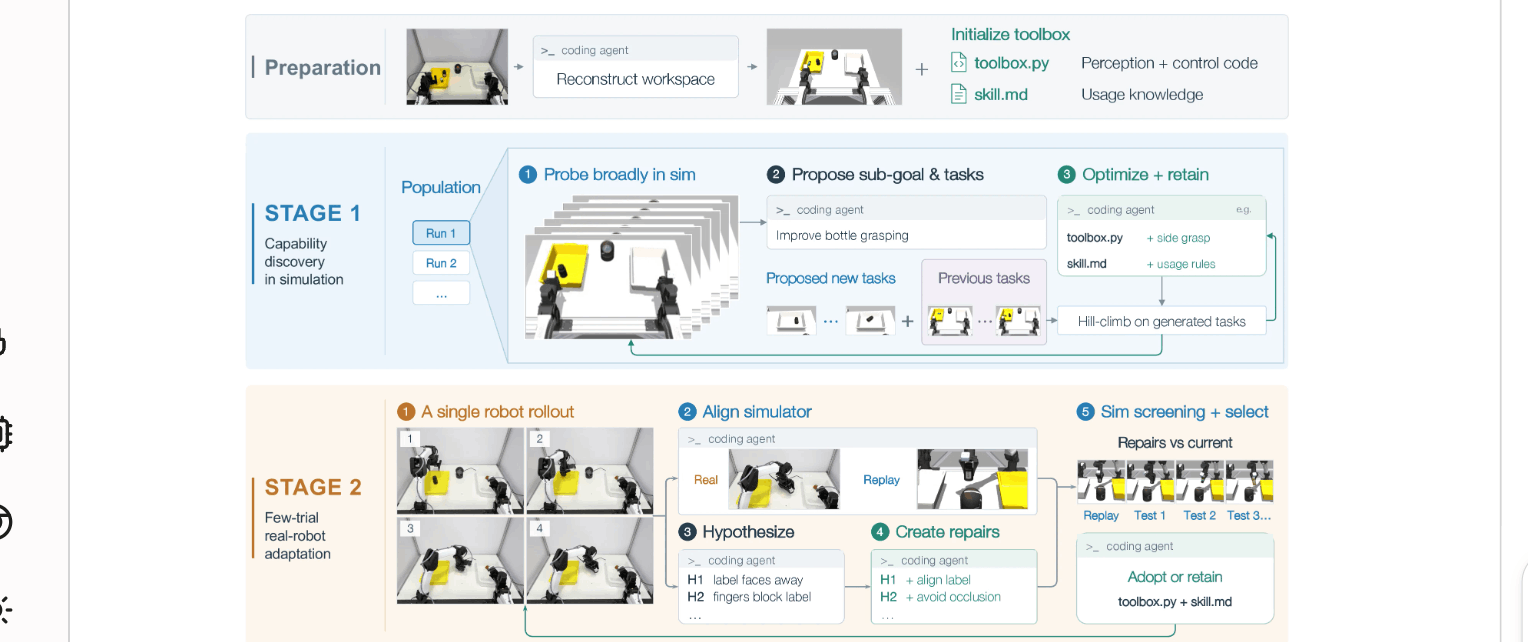
基于 code as policy. 考虑到 agent 真机试错有点贵,先让 agent 在仿真中获得 py 和 md 常识。然后有一个 idea: 如果真机失败,就微调仿真器复现真机失败情况(例如瓶子滑落),然后 agent 提出多个方案常识修复.
感觉很 make sense,但是怎么都这么 trivial,我们搞 agent policy 真的能节约 openai 一个 subagent 一分钟的时间吗.
ASENA (80)
⭐️⭐️ NVIDIA | https://www.alphaxiv.org/abs/2609.39207
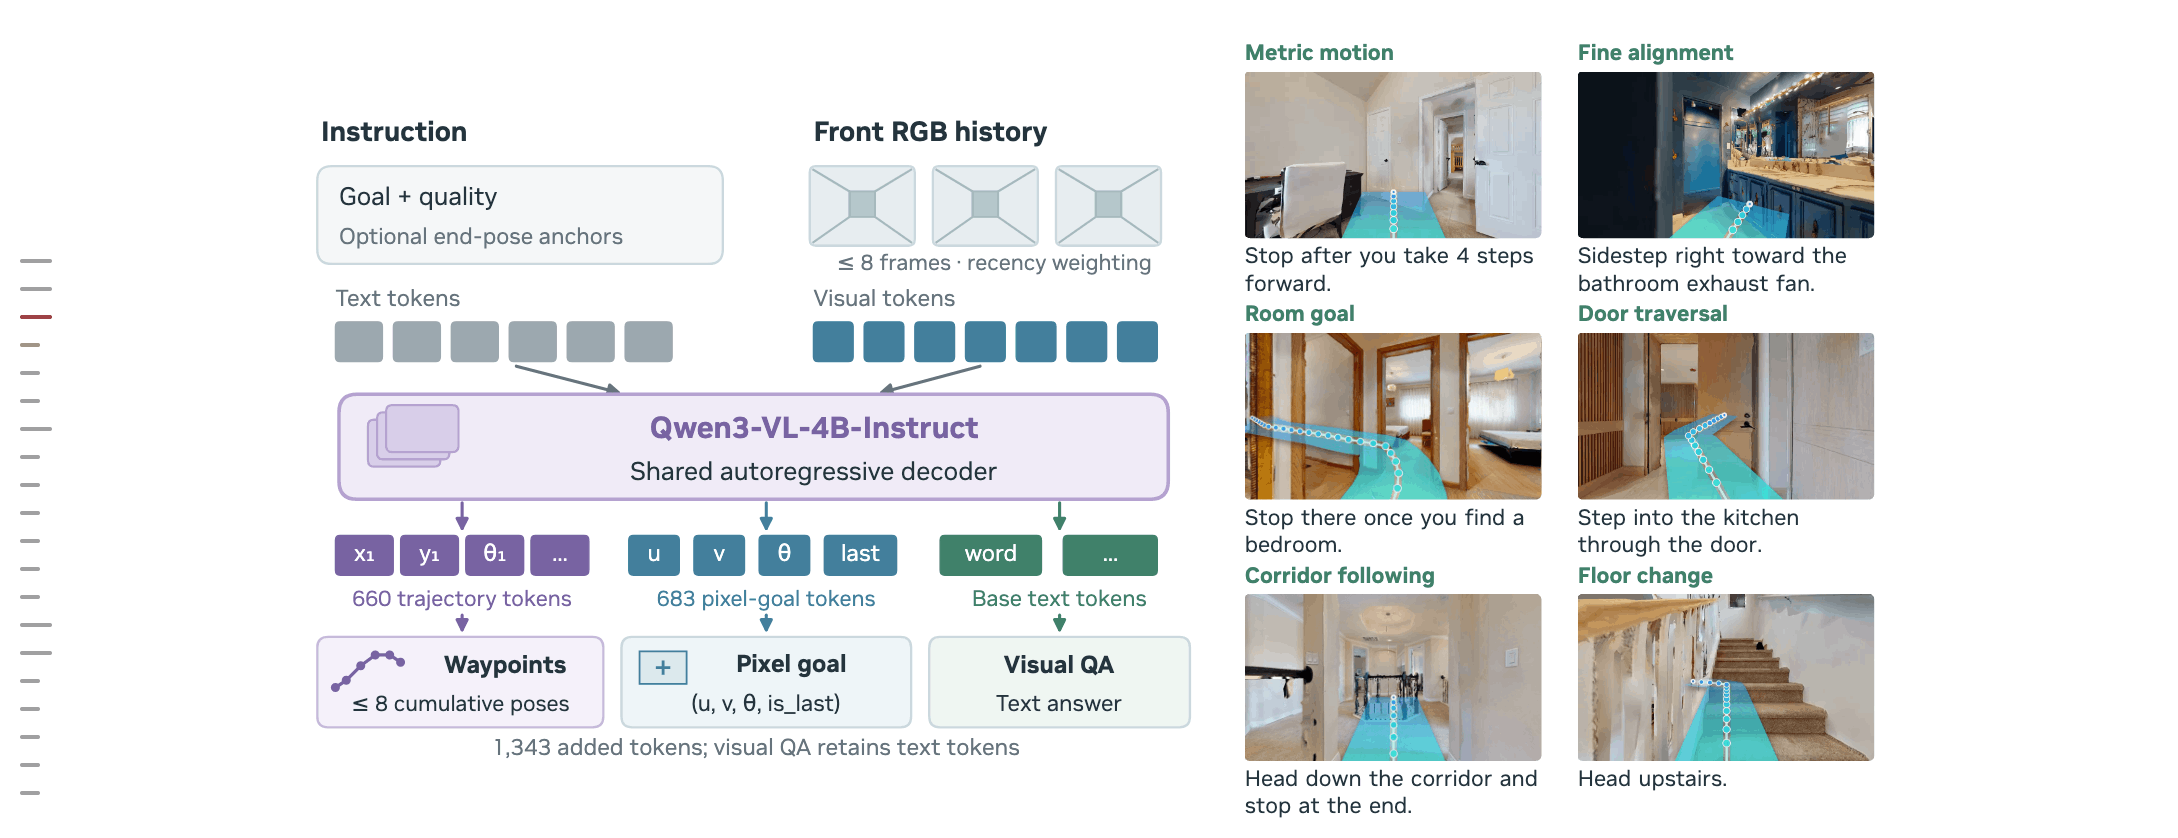
一个比较 trivial 的 agent => api => VLN 的工作. 得到指令会做一些规控检查.
HAND Me the Data (81)
⭐️ 南加州 | https://www.alphaxiv.org/abs/2505.20455
利用单次人手演示,从无任务标签的机器人操作数据中检索相似行为:先按视觉特征筛选,再按手部与夹爪的二维相对运动轨迹匹配,并通过LoRA微调策略。
也是比较 trivial.
Collage (82)
⭐️⭐️ Sateesh Kumar, UT | https://www.alphaxiv.org/abs/2508.01131
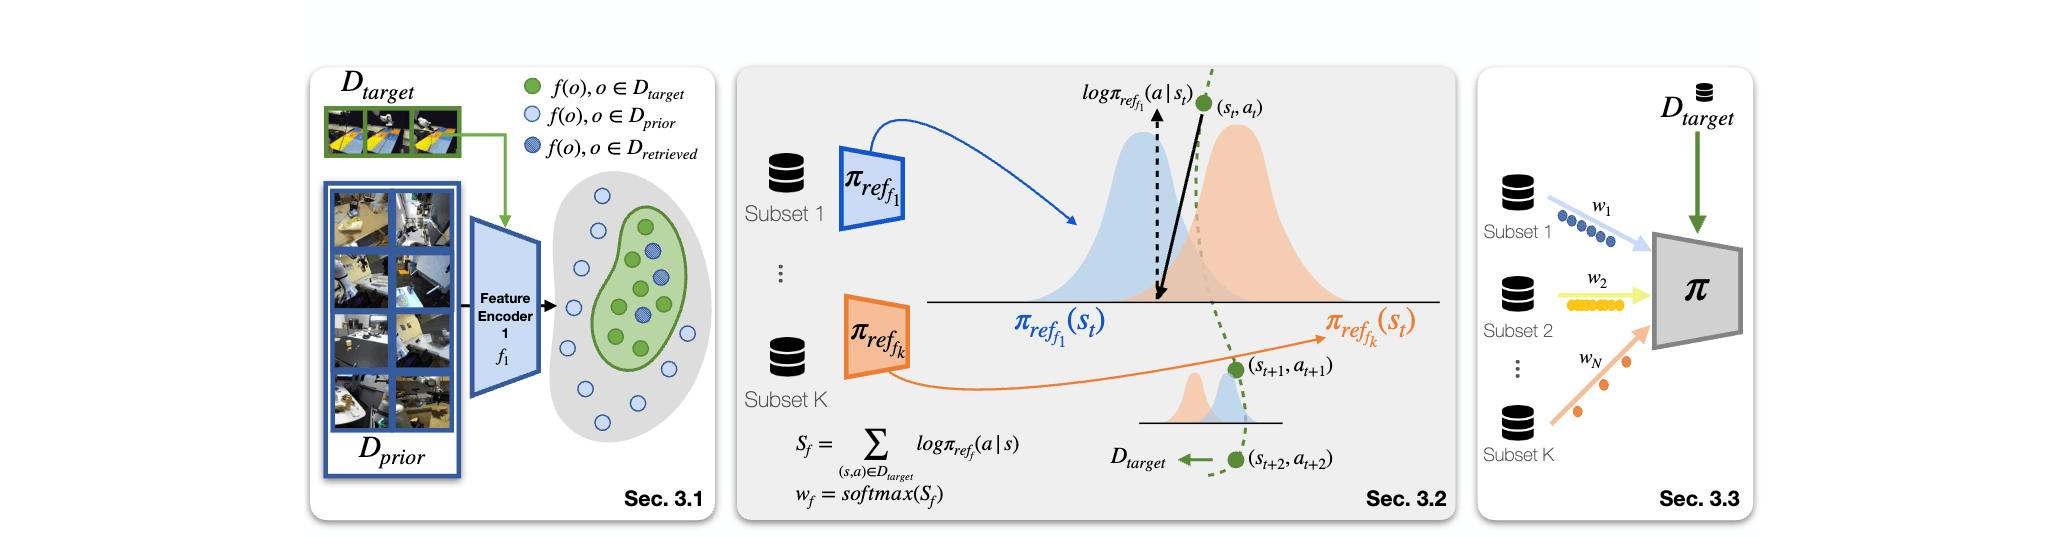
策略是带语言条件的 Transformer,输出头为 GMM。
视觉、动作、形状、语言分别用 DINOv2、光流特征、PointNet++、文本嵌入检索示范;再让每种检索结果各自训练一个参考策略,看它对目标示范动作的预测似然,似然越高,分到的权重越大,最终训练时就越常采样该来源的数据。 %%%%