SmolVLA (67)
⭐️⭐️⭐️ huggingface | https://www.alphaxiv.org/pdf/2506.01844
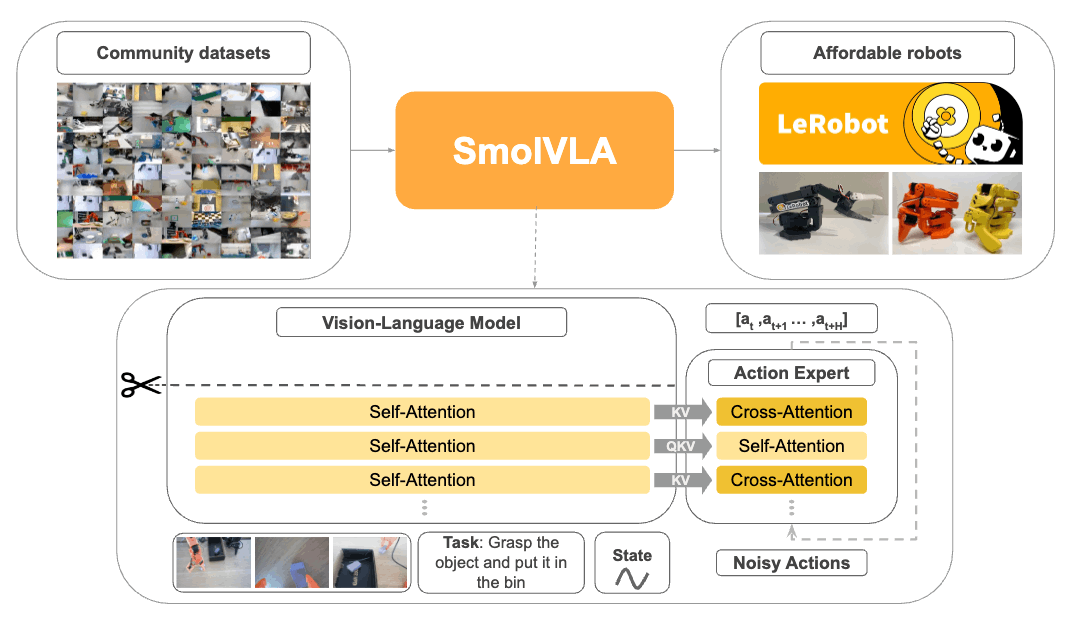
裁剪 MoT 并交错使用 CA 和 SA 以让模型更轻量化.
VPP2 (68)
⭐️⭐️⭐️ 郭彦江, 陈建宇,清华&星动纪元 | https://www.alphaxiv.org/abs/2610.10270
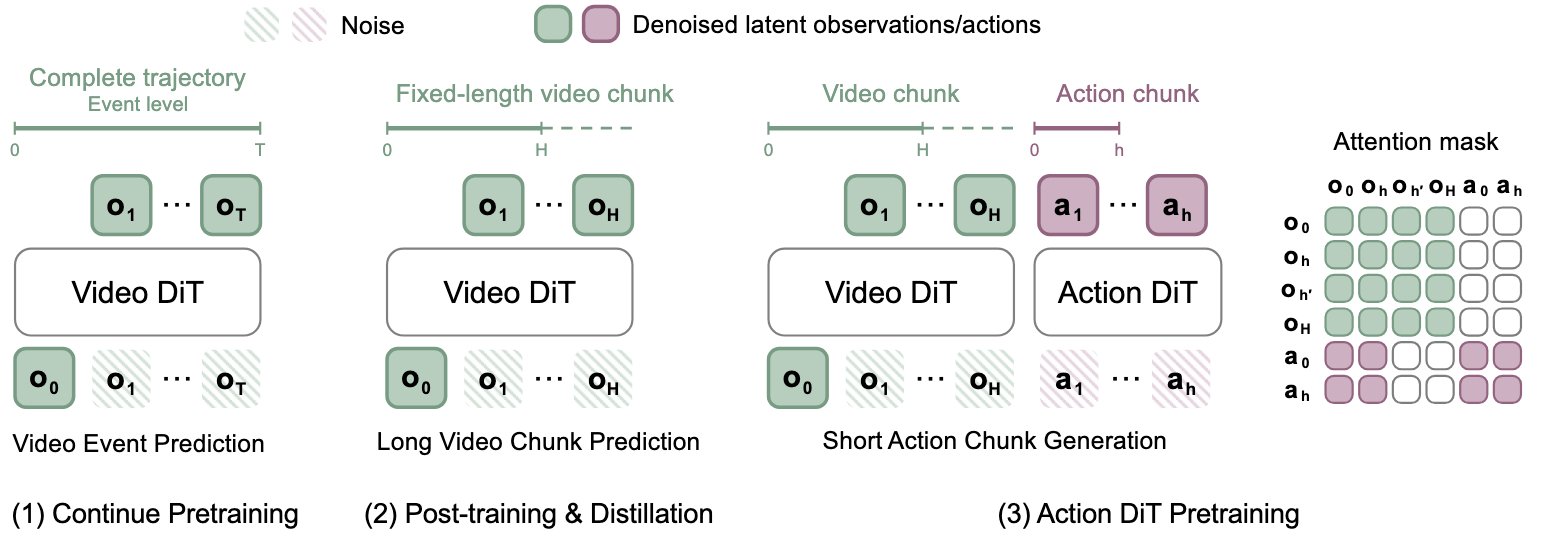
架构没变化仍然是 MoT IDM. 数据上扩展了 ego 和通用视频,并按照语义切分为 1-12 秒事件,预训练让 VM 完整预测整个不定长事件; 要求事件内的文字描述十分明确. 训练流程三阶段如上图.
消融表明按事件预测显著提升按照指令预测视频的效果;VLM 上层规划大幅提升 SR. 发布时登顶 dojo (32.26%),但 dojo 并没有使用 VLM 上层规划.
注:VPP1 的架构 query UNet 中间特征交给 AE,但是本作向 MoT 投降了.
Ctrl-world (69)
⭐️⭐️ 郭彦江, Chelsea Finn, Stanford | https://www.alphaxiv.org/abs/2510.10125
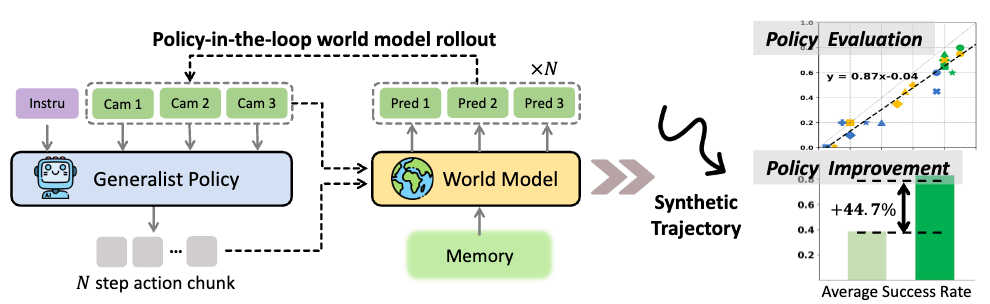
WM simulator rollout,然后人工从中选择后训练数据
EgoRecovery (70)
⭐️⭐ 葛祖浩,周宇辰,贾晓松, Yu Gang Jiang, FDU&SimpleAI | https://www.alphaxiv.org/abs/2607.19745
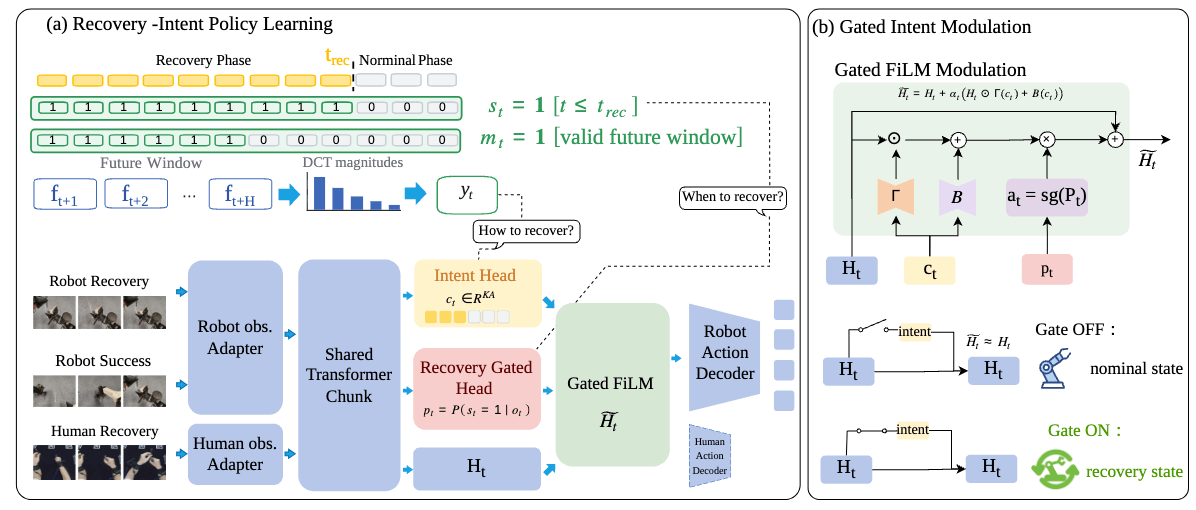
从手工设计的失败情形录制人类 Ego 纠正数据,以及机器人rollout失败的时候,人类手动摆出失败配置并纠正; 提取意图调制 Gated 动作解码
PhysicalRSI (71)
⭐️⭐️ mmlab | https://mmlab.hk/research/PhysicalRSI
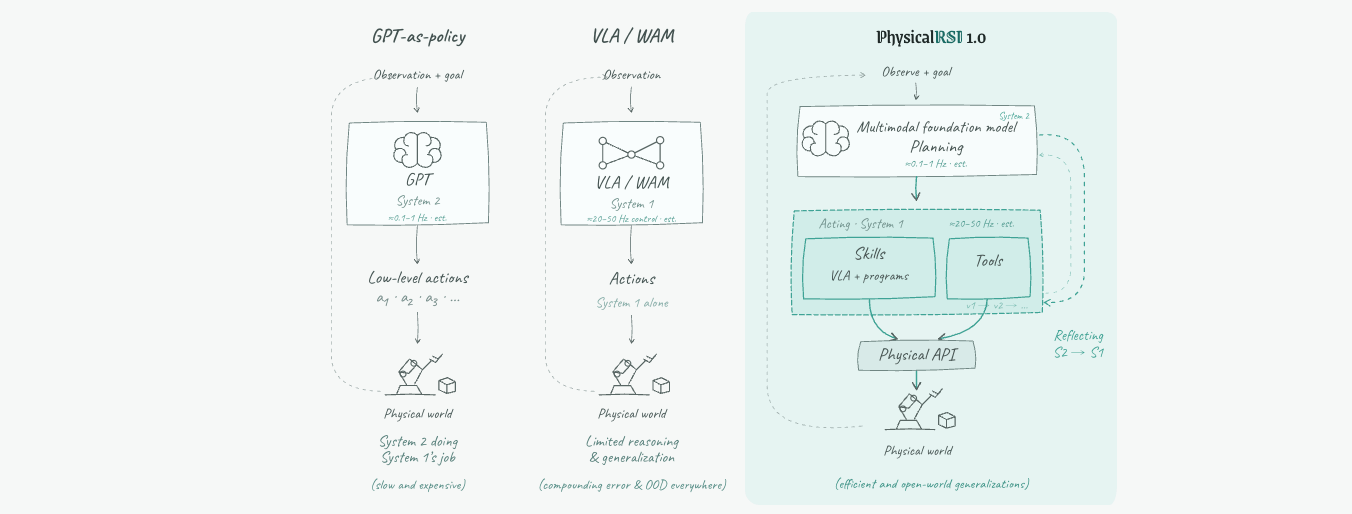
让 GPT 自己决定 调用 VLA / “move_eef” “rotate_wrist_pitch” / task-specific 规控,写 SKILL.
RealtimeWAM (72)
⭐️⭐️ Chengtao Lv, Wena Wang, NTU & 北航 | https://www.alphaxiv.org/abs/2610.06617
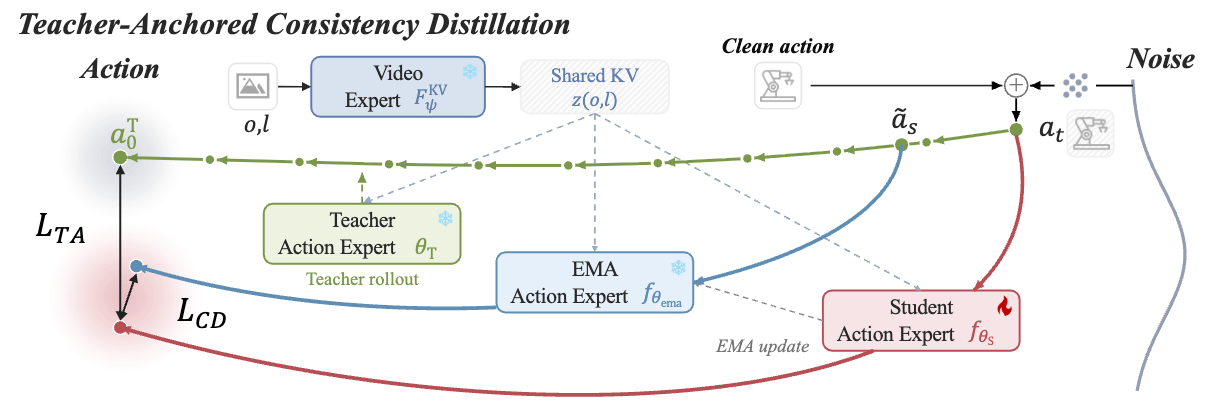
TACD: 就是蒸馏目标改为 teacher 多步 rollout 的平均速度. 提点 1-2%. 但是显然,这样训练就变慢了.
CEWP: 修改 MoT 计算顺序,同时计算 WM 和 AE 的同层 block. 提升 GPU 利用率. 并没有异步.
GPT-6 Astra as Embodied Policies (73)
⭐️⭐️ 银河通用 | https://www.alphaxiv.org/abs/2609.38537
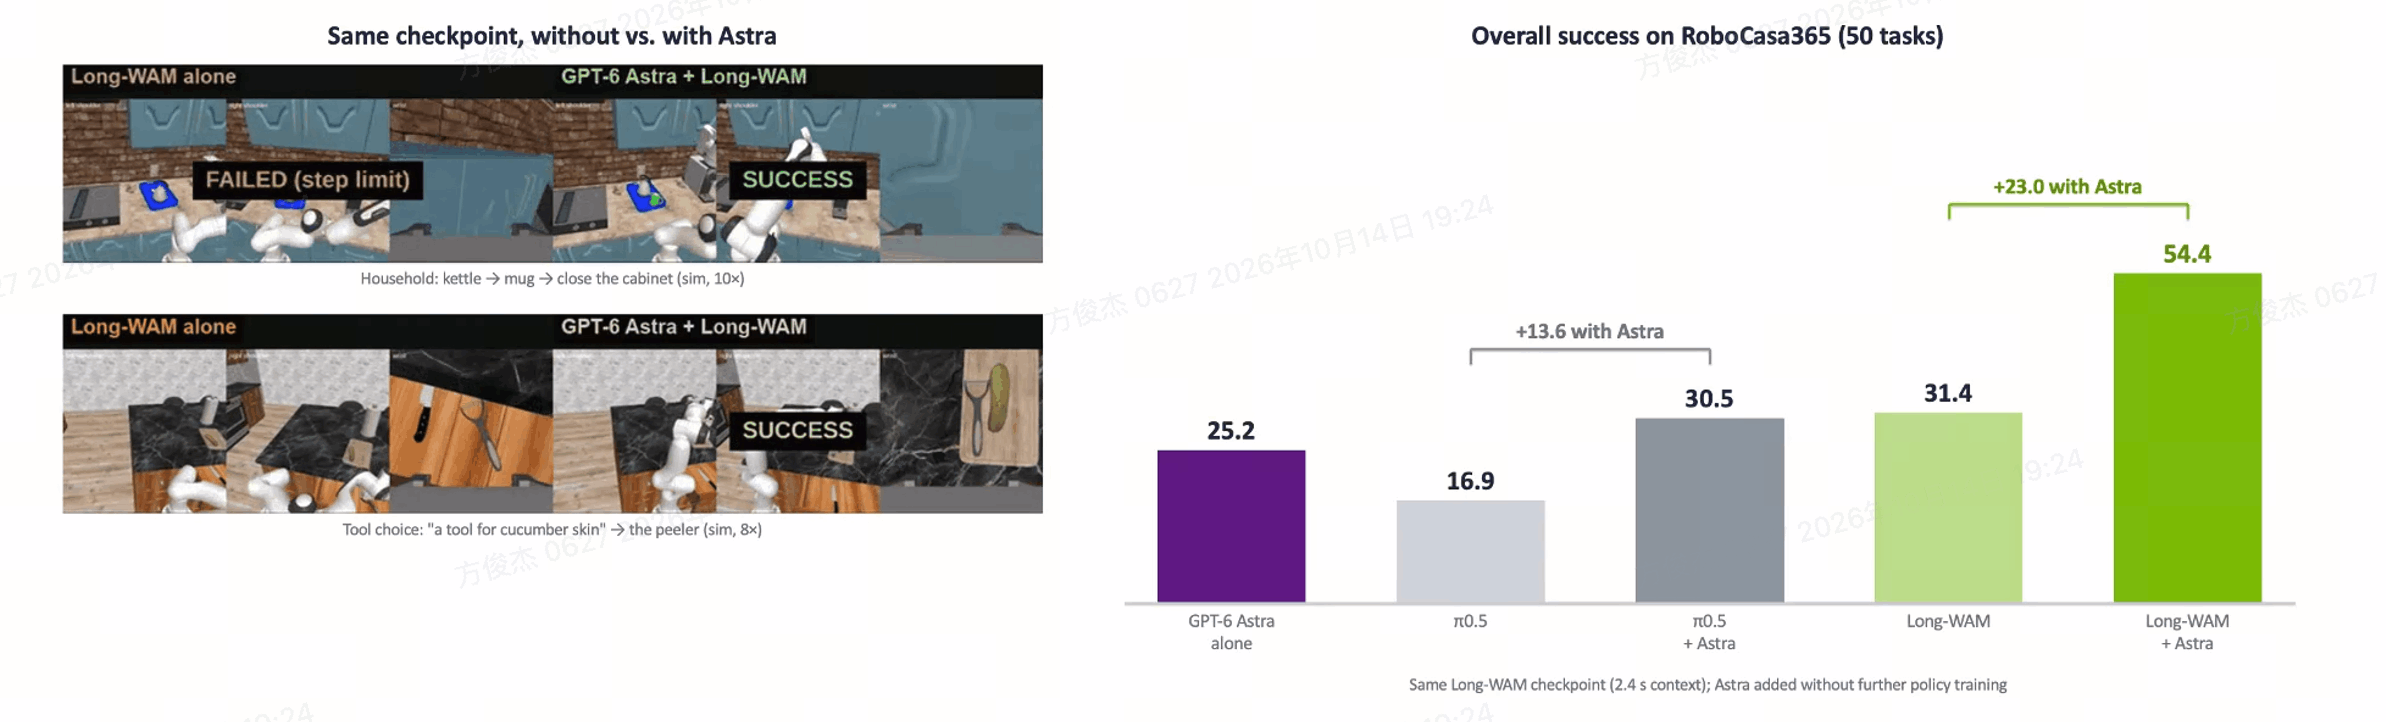
对于 pi05 提交的每一个 chunk,经过 FK 后 GPT 直接看 image + chunk,决定是否接管. Astra 选择接受其前 1–15 步,或替换为 1–5 步的末端执行器修正动作. 仿真分数比单纯 GPT 和单纯 pi05 都高.
每个 episode 消耗 token 12M+.
LongWAM (74)
⭐️⭐️⭐️⭐️ 对 WAM 加长 video history 推荐开启 AR | Wei Huang, Yukang Chen; NVIDIA | https://www.alphaxiv.org/abs/2610.10528
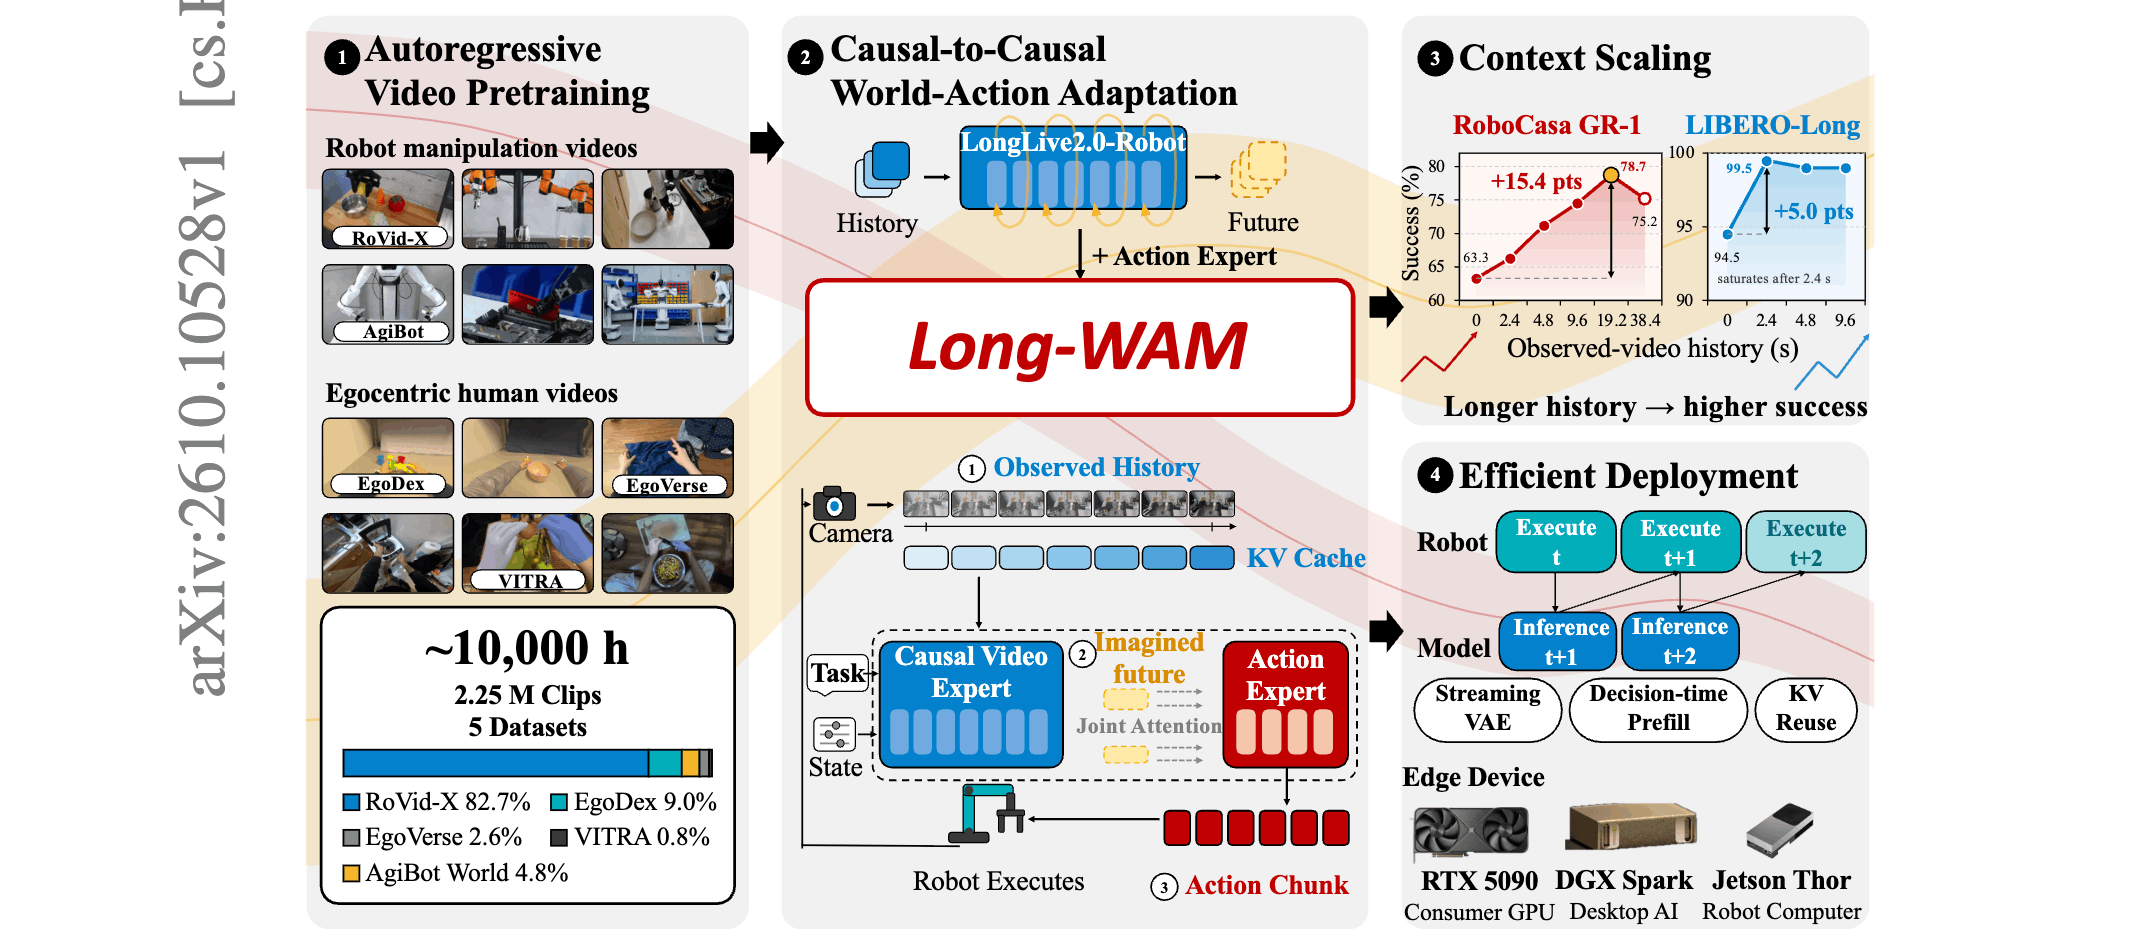
本文发现对 WAM 加长 video history 必须开启 AR,也就是预训练和后训练的 video 输入部分用 causal attention & 块级 teacher-forcing,而采用双向注意力不会随着历史长度提点. 仿真上 RoboCasa GR-1 提点 17%.
然而,几乎没有真机实验 result,真机 demo 是比较 trivial 的 picknplace. 而且每个 history 长度单独训练一个 ckpt.
AI 椰青分享: