JEPA-WAM (59)
⭐️⭐️⭐️ LLM/VLM aligned to JEPA | 👤 中国人民大学, Yihan Lin, Cheng Chi 和 Jing Zhang | 🌐 | 📃 2608.09381 | ✨ | 📂
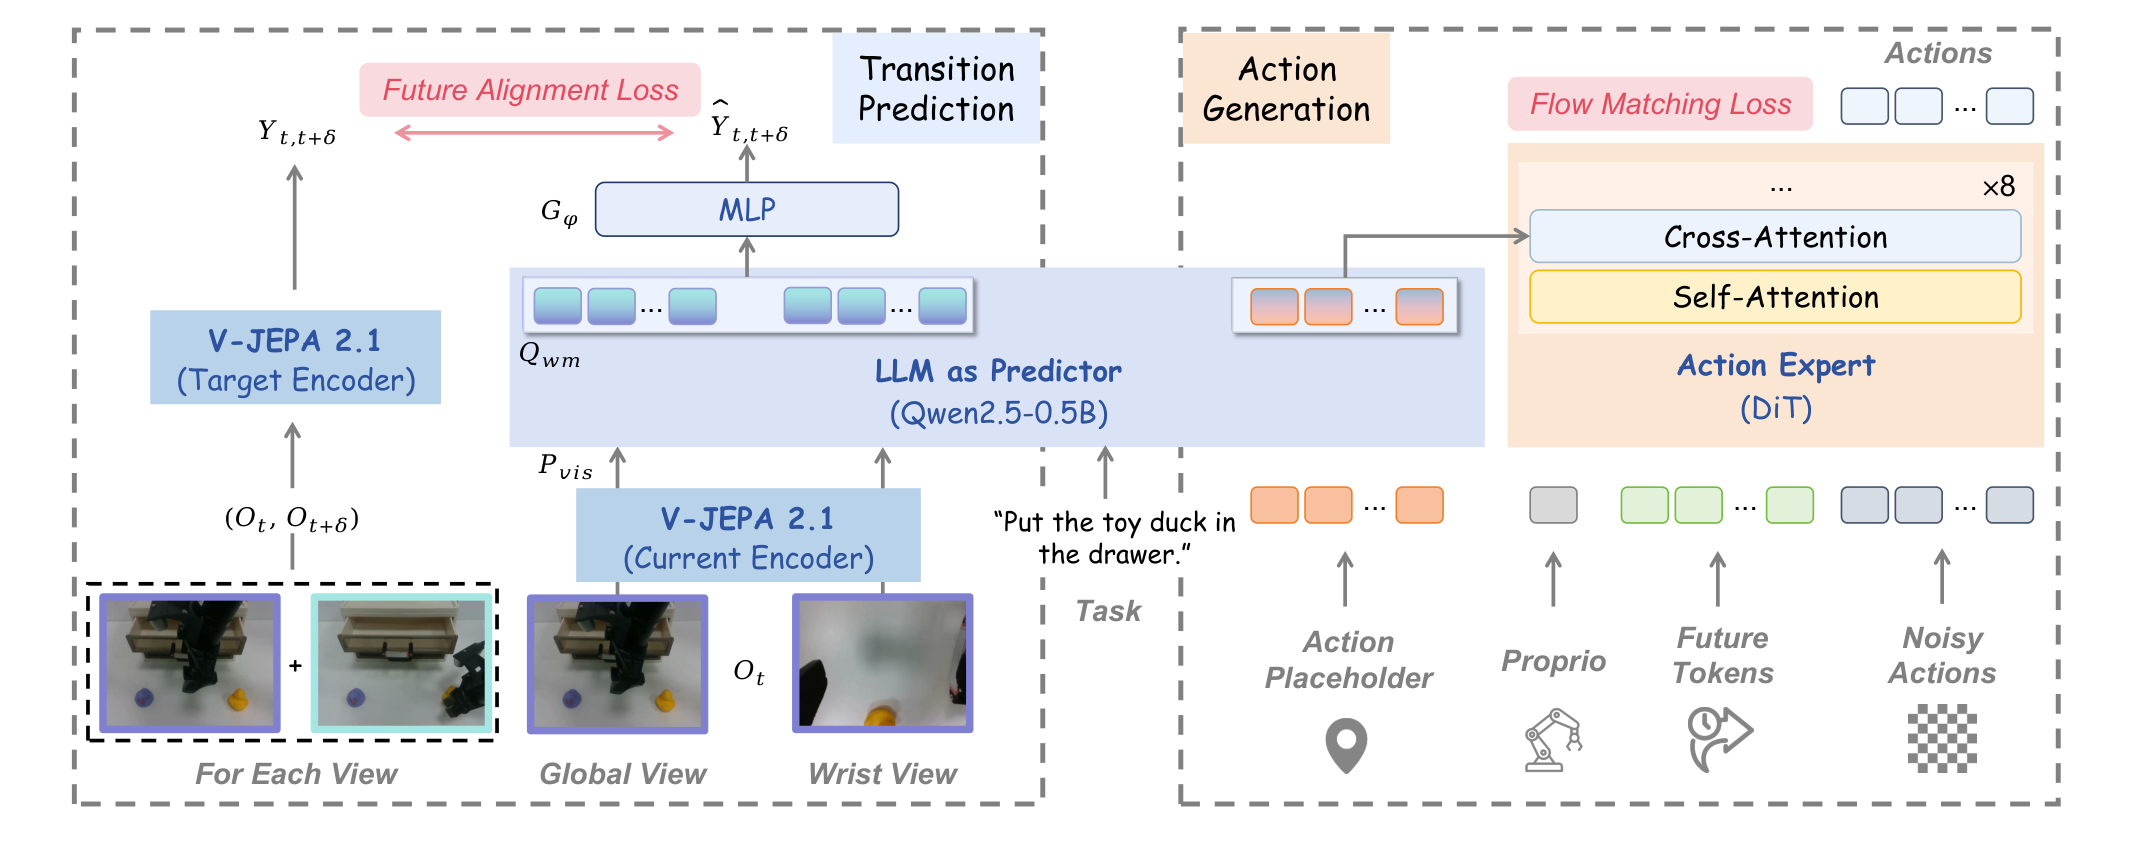
用 LLM 输入当前图像 JEPA,对齐未来几帧 JEPA [1]. 同时 LLM 输入 action placeholder,将其隐状态用作 AE 的 cross-attn [2]. JEPA 辅助 loss 还可以作为插件加入 pi05,在 LIBERO-plus 上提点 1.8,Robotwin Clean 提点 9.2,Random 提点 0.3.
- 视觉编码:视觉 token 经 1024→896→896 的两层 MLP 送入,其视觉位置的隐状态再经 896→2048→1024 的 MLP 逐 patch 余弦回归该目标.
- 奇怪 tokens: AE 有几十个 future tokens 似乎没有监督,也不知道是干啥的.
HIL-UMI (60)
⭐️⭐️⭐️ robot-tree teacher-forcing umi dagger | 👤 西安交通大学, Zimu Han, Hao Dong(北京大学 和 PrimeBot) | 🌐 | 📃 2609.20659 | ✨ | 📂 |
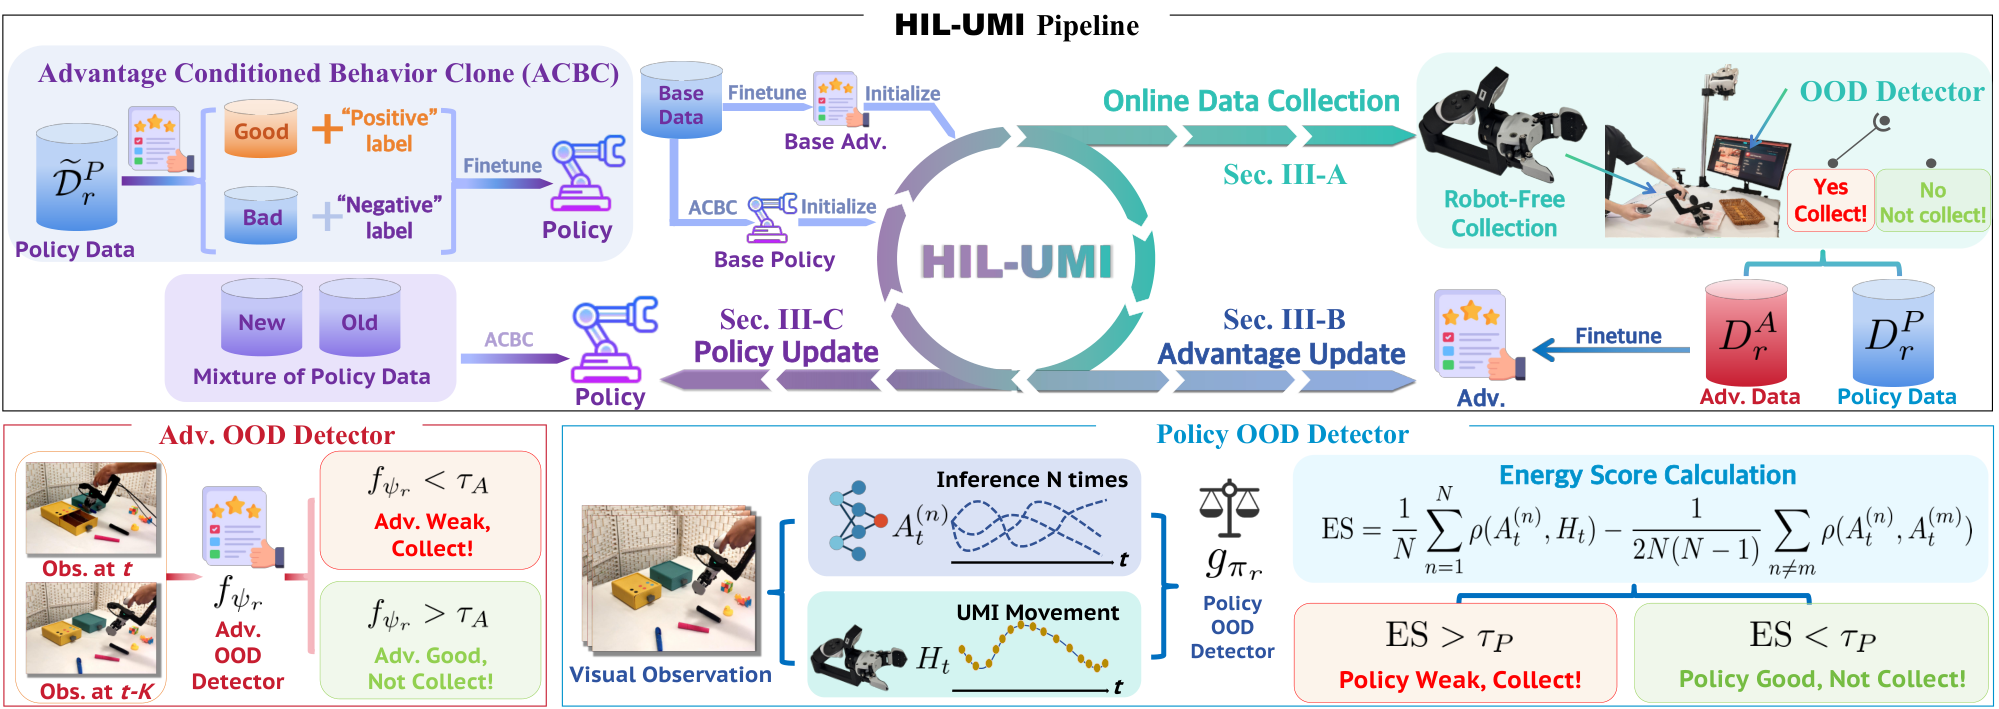
他是这样做的:先训一个 pi05,然后人类继续演示的同时把 obs 输入 policy 推理(但不执行),如果人类 chunk 和 policy chunk 相差大就认为 OOD 并让人类从当前位置继续采集并作为 dagger 数据集. 另外,人类采集数据还会用来训练一个优势器(假定人类总是优的),这个和 OOD 判别无关,只是给数据集打标方便进行优势 conditioned 学习的.
比较奇怪的是请求介入的时候人类只是继续刚才的动作而已,完全等价于在 offline umi dataset 上直接做 odd detector 筛选“dagger”数据集,因此 online umi 这个核心 claim 没立住.
- Energy Score(OOD Detector) 衡量人的动作块与这批采样点的距离并减去采样点自身的分散度;
- advantage 模型从相隔 50 帧的一对观测预测相对进度
X-VLA (61)
⭐️⭐️⭐️⭐️ 每个数据源独立 learnable embedding & action proj | 👤 清华大学智能产业研究院 AIR, 郑良亮, 王泰/詹仙园 | 🌐 | 📃 2510.10274 | ✨ | 📂
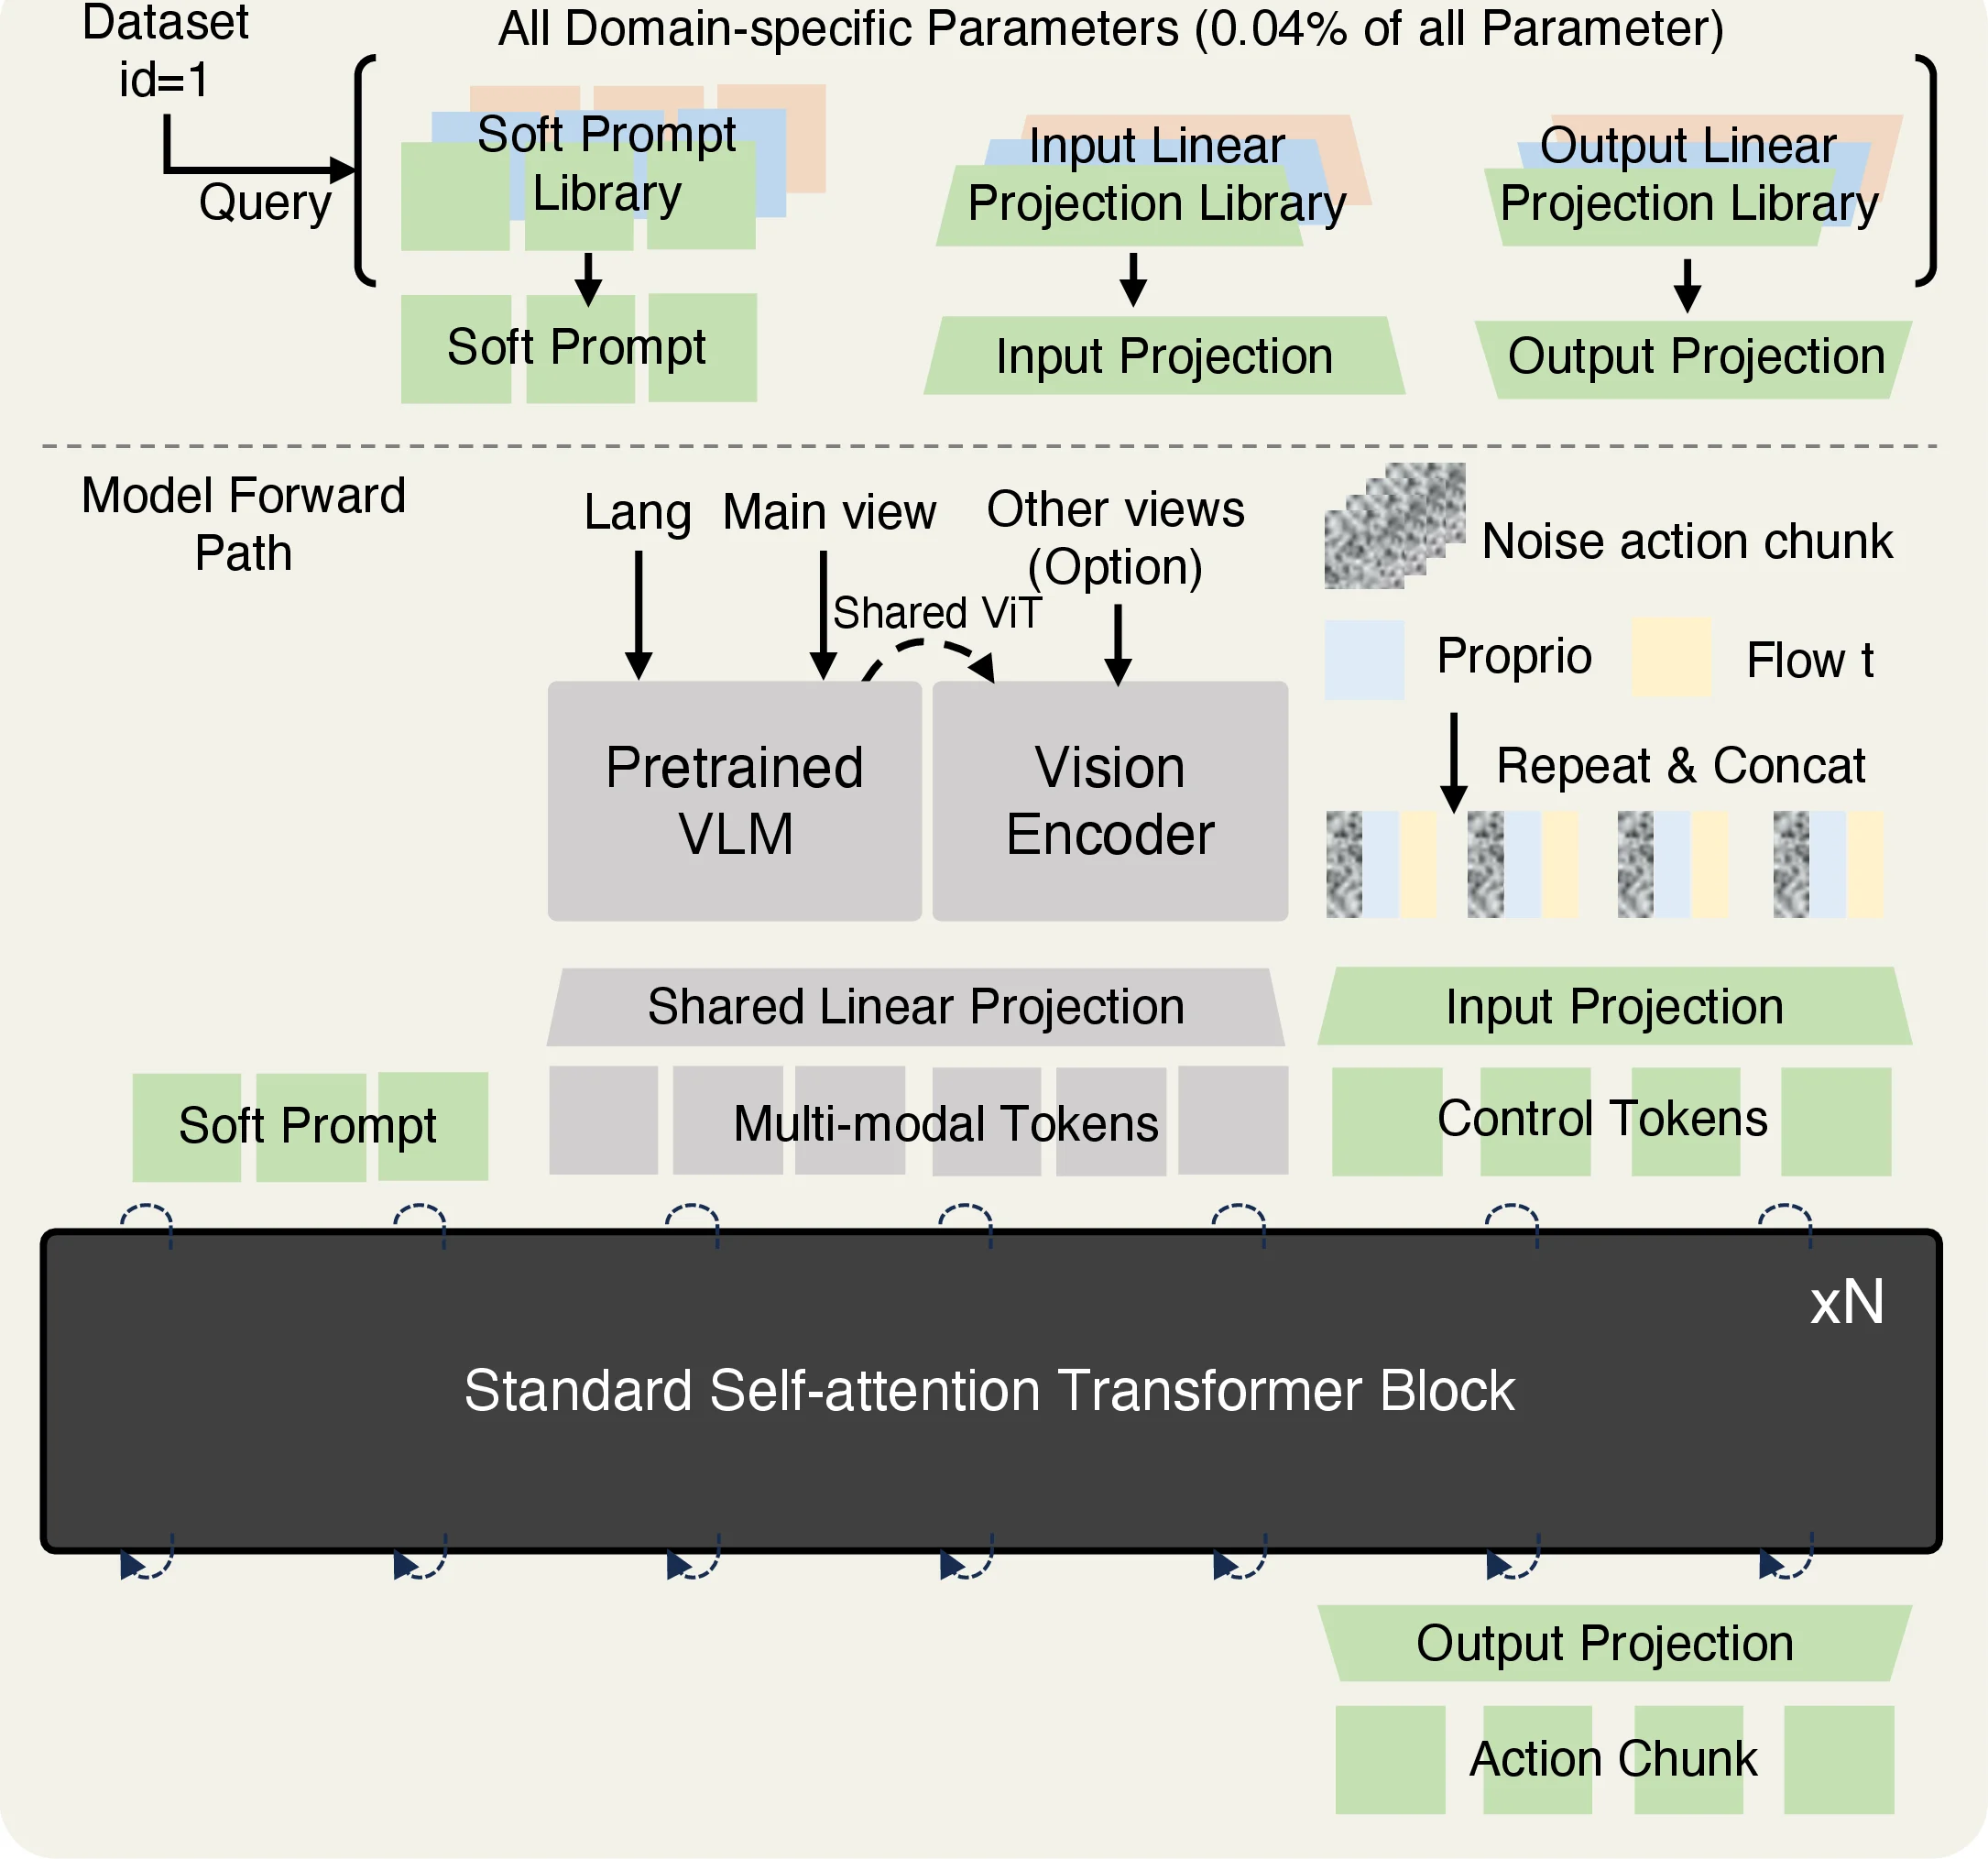
本文发现随意混异构数据会掉点,于是提出给每个数据源一个独立 learnable embedding (32 tokens, 叫做 soft prompt,拼接到 encoded vl 之后) 以及独立 action input/output proj,感觉很 make sense. 后训练先冻结主干给新本体 warmup library,然后解冻主干或LoRA. Cascaded 架构. 性能截至今天依然能打.
- 上图中间 shared linear proj 有误,代码中 main 和 others 为独立 proj.
- 腕部视角确实不经过 vlm,不知道为什么.
- noisy action 那里 proprio 和 flow t 确实是重复拼接的.
- AE 输出
[B, chunk_t+T_vlm+T_aux+32, 1024]以后直接过DomainAwareLinear(1024, 20). soft prompt 在最末尾.
ReconVLA (62)
⭐️⭐️⭐️ https://www.alphaxiv.org/abs/2508.10333 | Wenxuan Song, Haoang Li, 港中深广
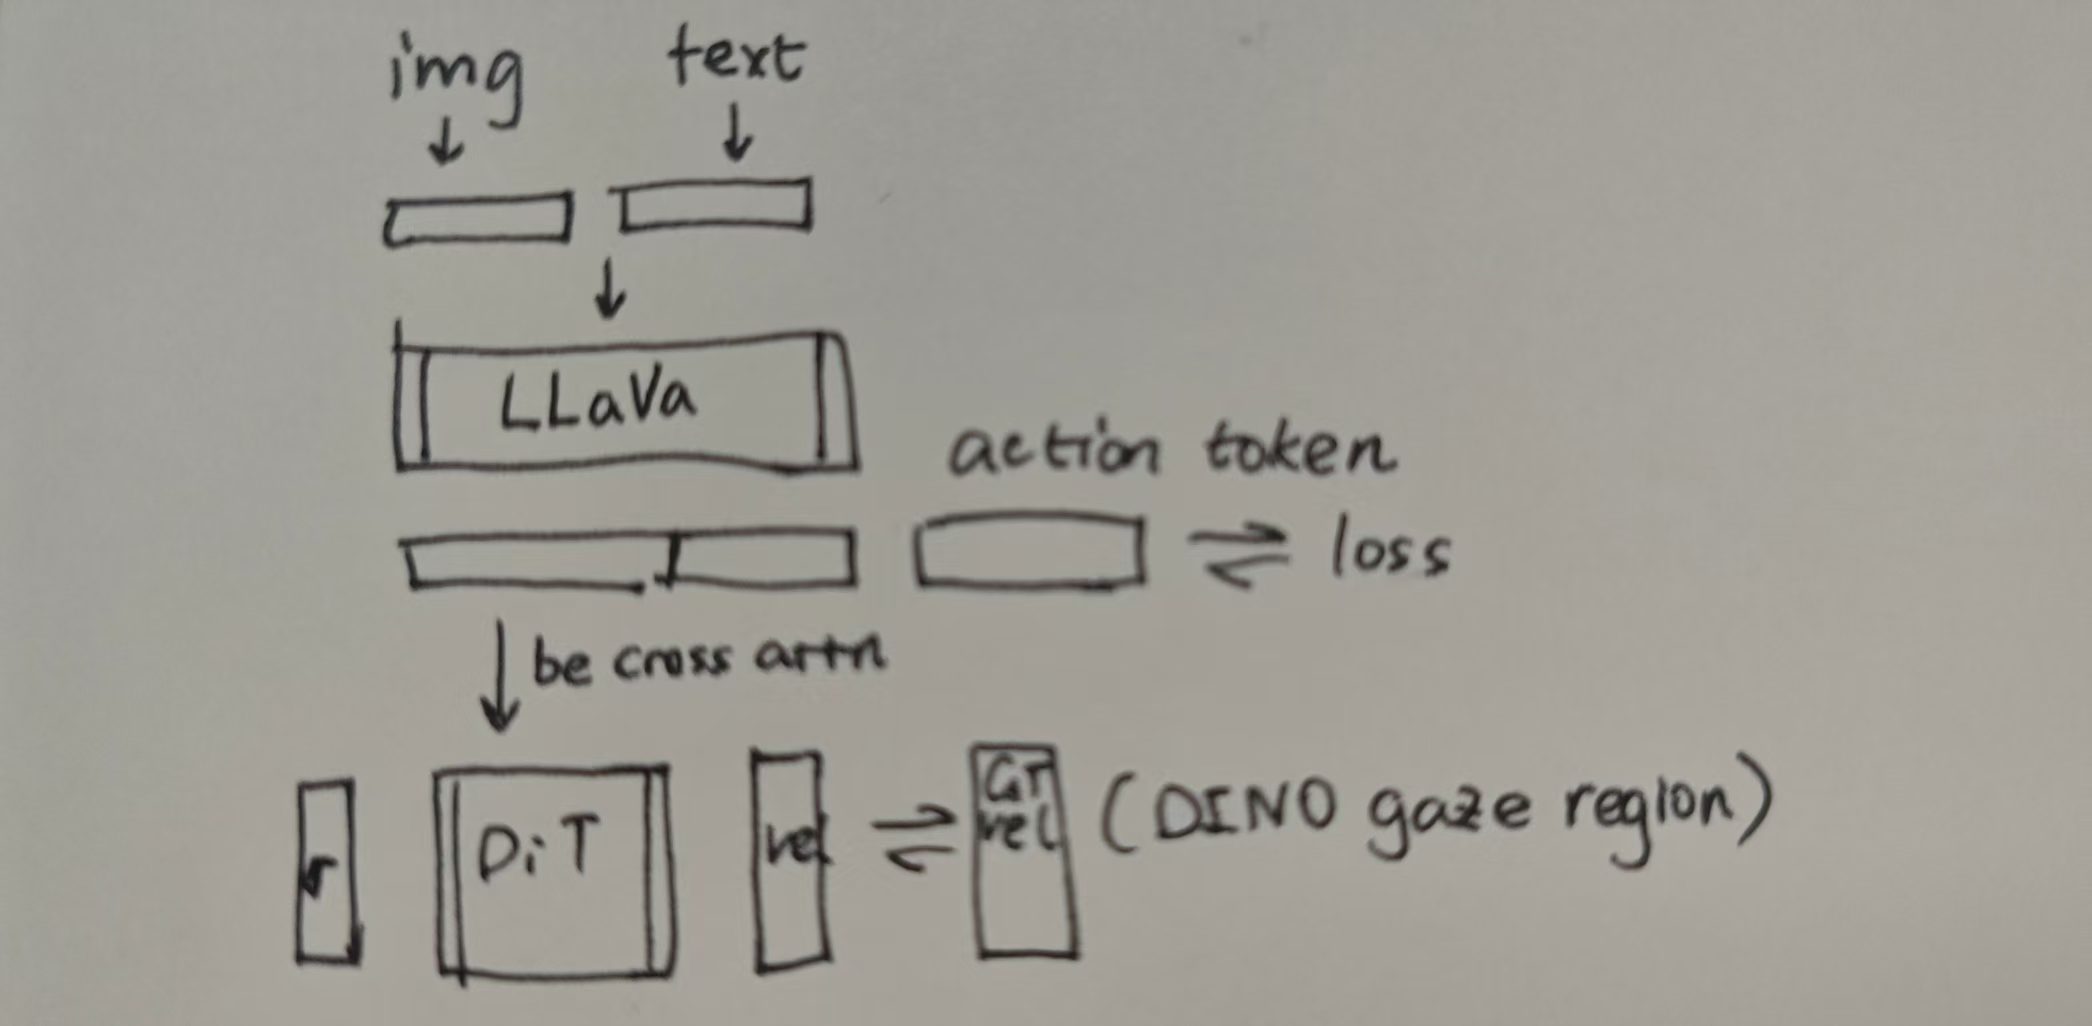
LLaVA 自回归出 action token, 同时 img hidden 作为 独立 DiT 到 DINO gaze region 的 condition 来监督.
Faster-WAM 华中科 (63)
⭐️⭐️⭐️ 推理时 video 仍前向一次 + SparseMoT | 👤 华中科技大学, Weiheng Zhao, Xinggang Wang | 🌐 - | 📃 2608.04404 | ✨ | 📂
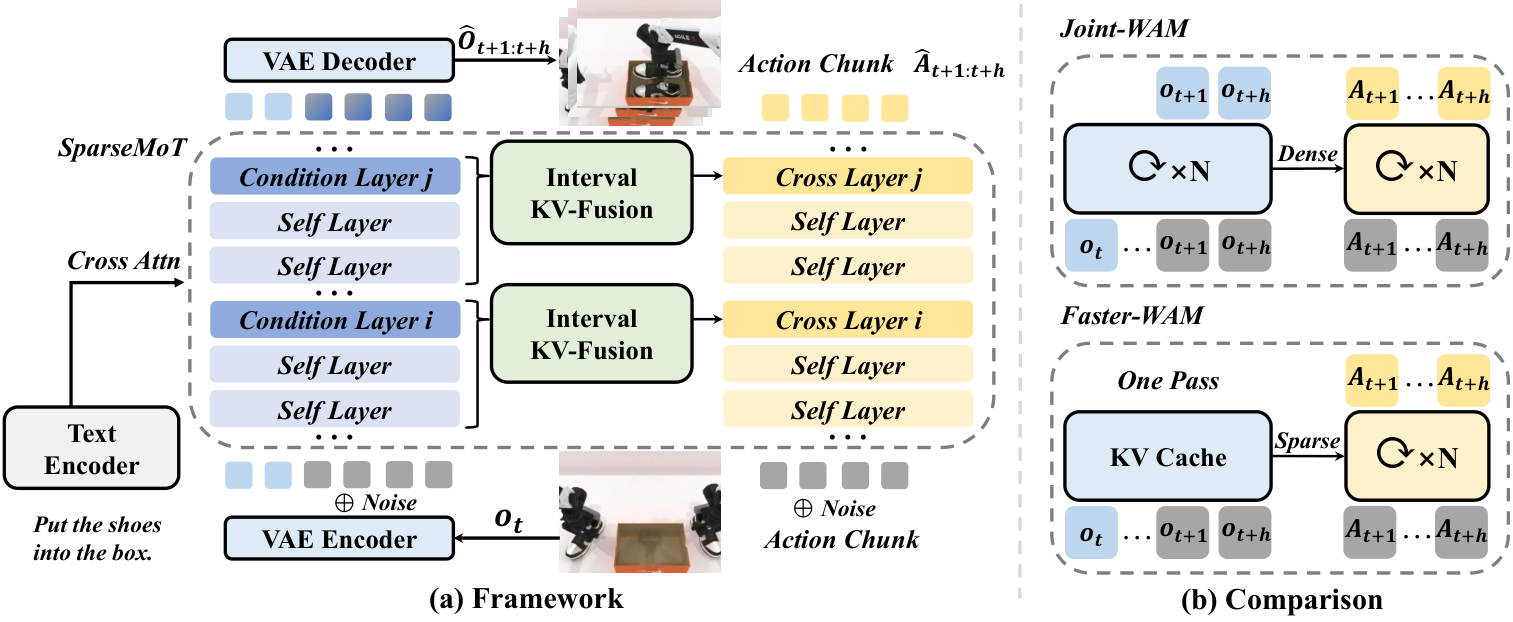
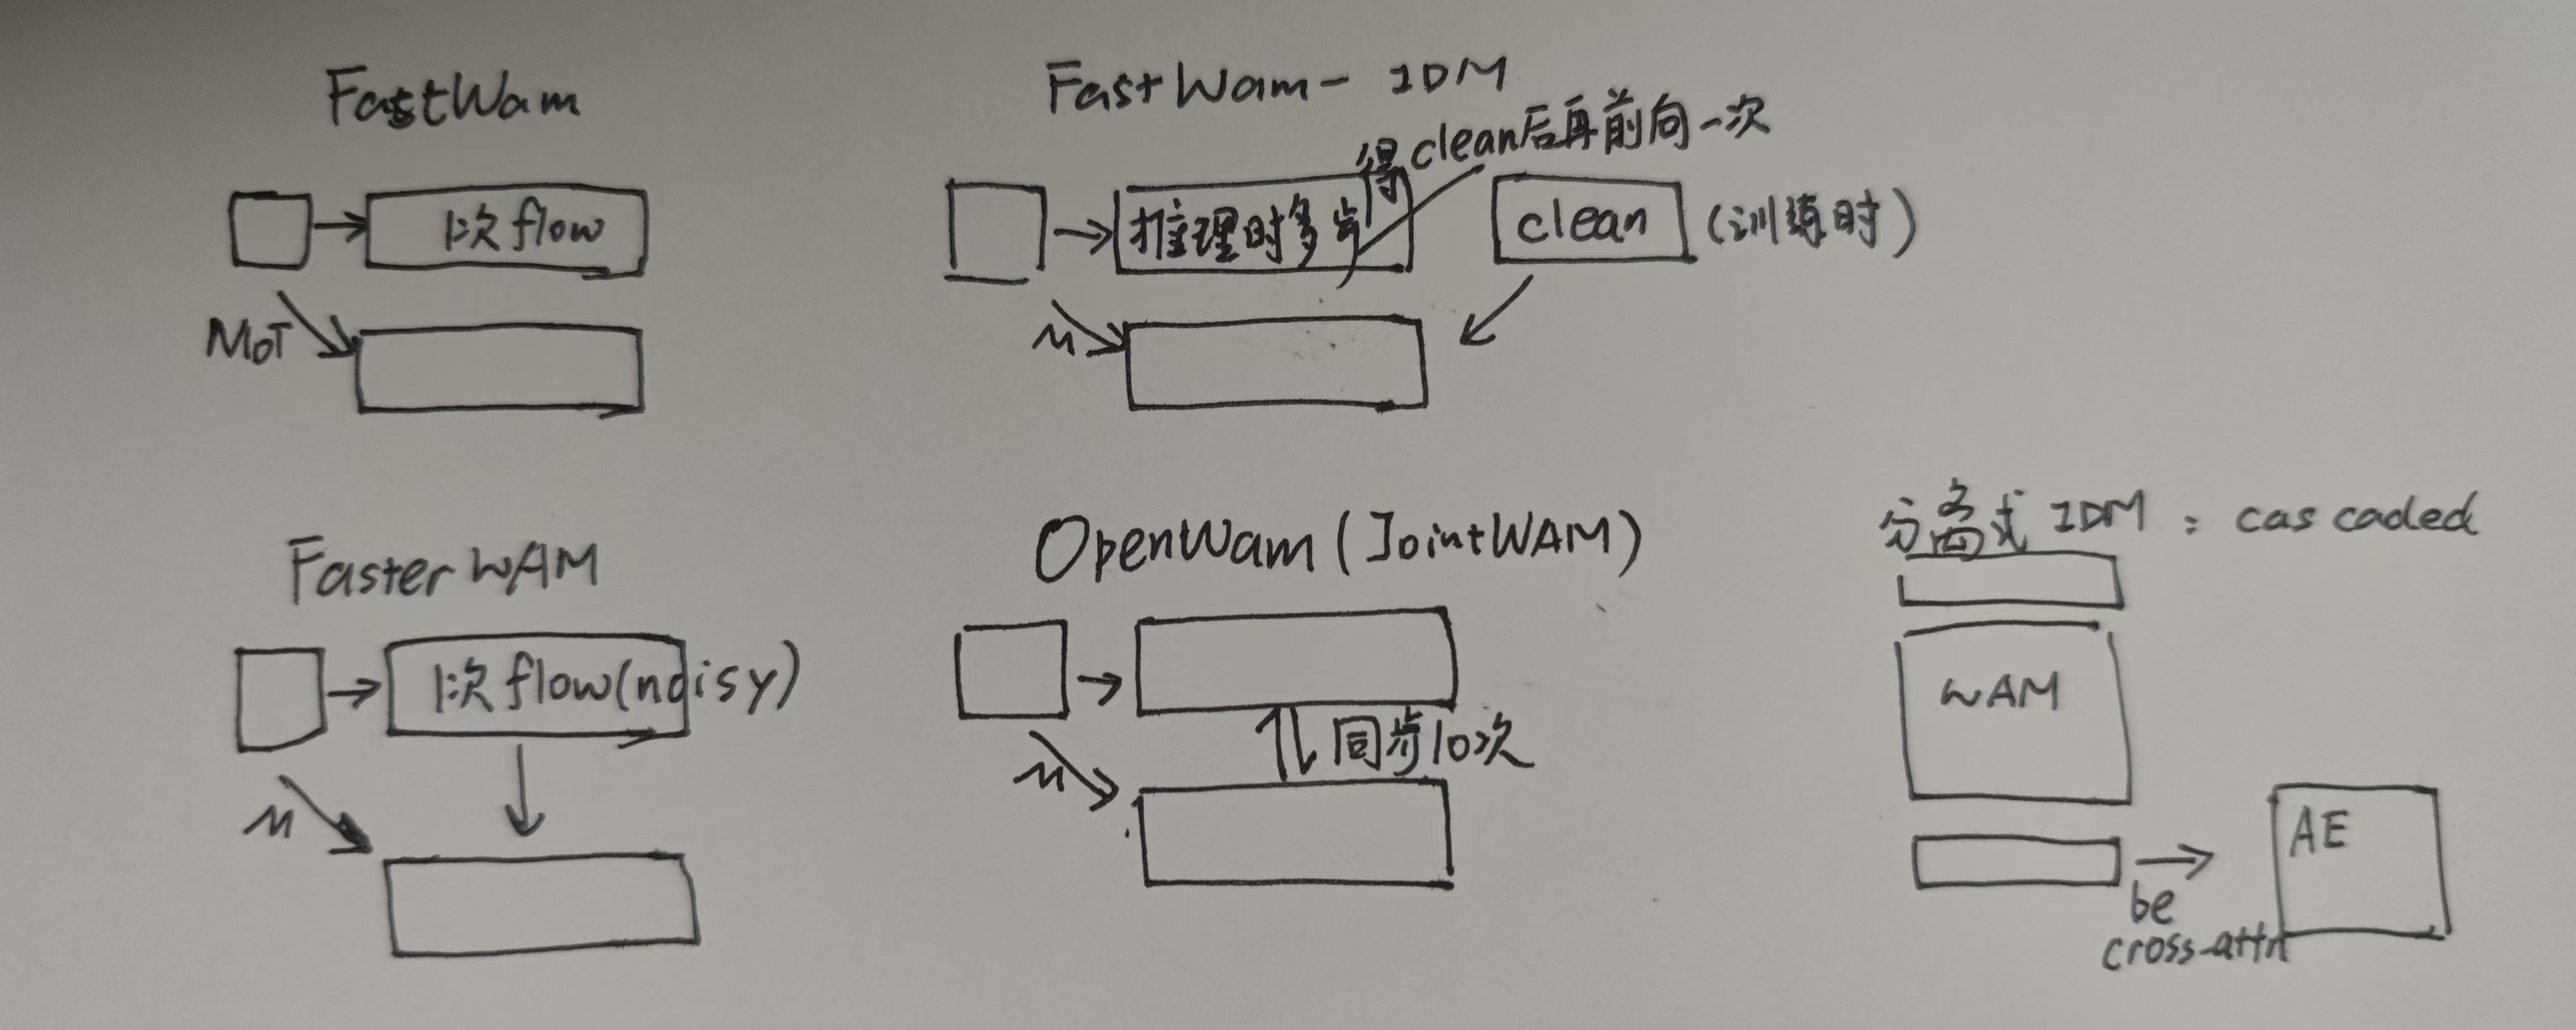
video 仅前向一次,action 能看到 video. 训练时,这个前向一次的 velocity 也会被监督(和 fastwam 一样). SparseMoT 的 action 每 4 层看一次 video,并且看的是 learnable 加权的 4 层 video kv cache,文章称 Dense < Stride-4 < Stride-4 & 加权.
G0.5 (64)
⭐️⭐️⭐️ 星海图 https://www.alphaxiv.org/abs/2608.11739v1
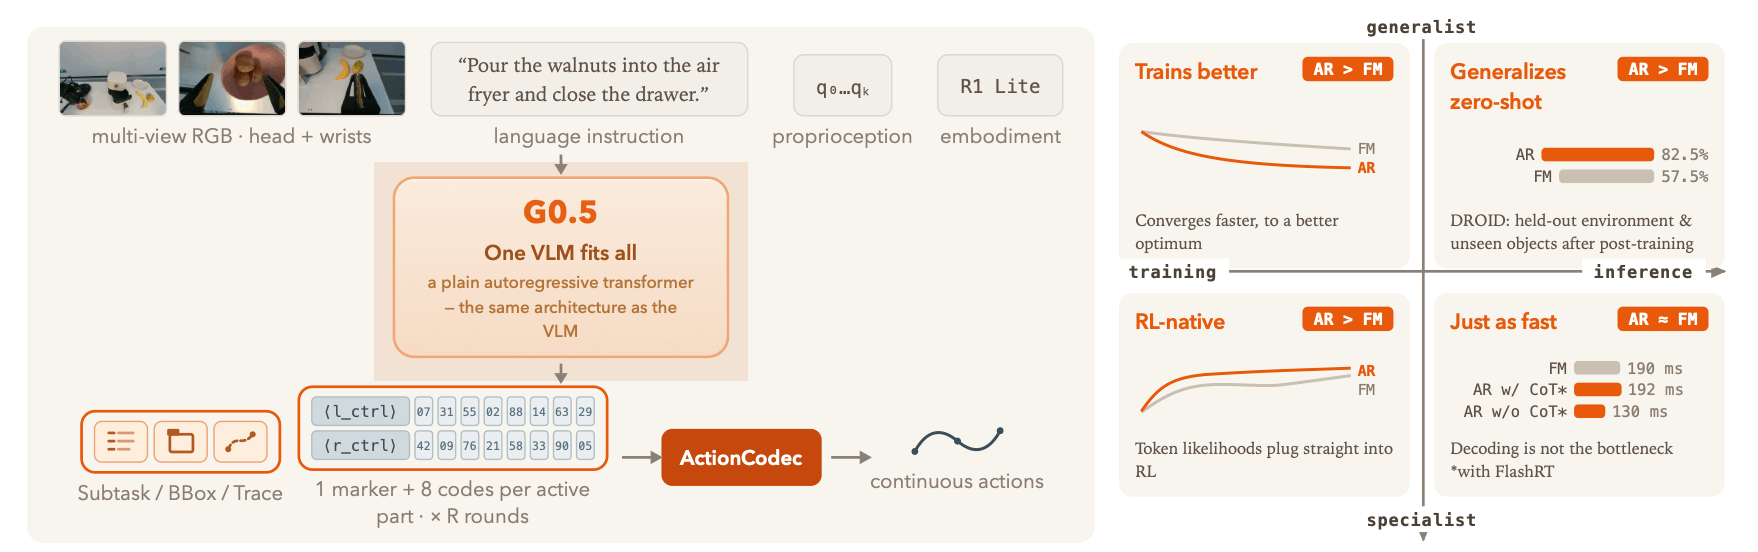
带 ActionCodec、CoT 和 MEM visual memory 的自回归 VLA,实验 AR > FM. 然而实测 AR 并没有完整开源,开源的 FM 效果倒还行.
InternW0 (65)
⭐️⭐️ https://www.alphaxiv.org/abs/2609.27656v1
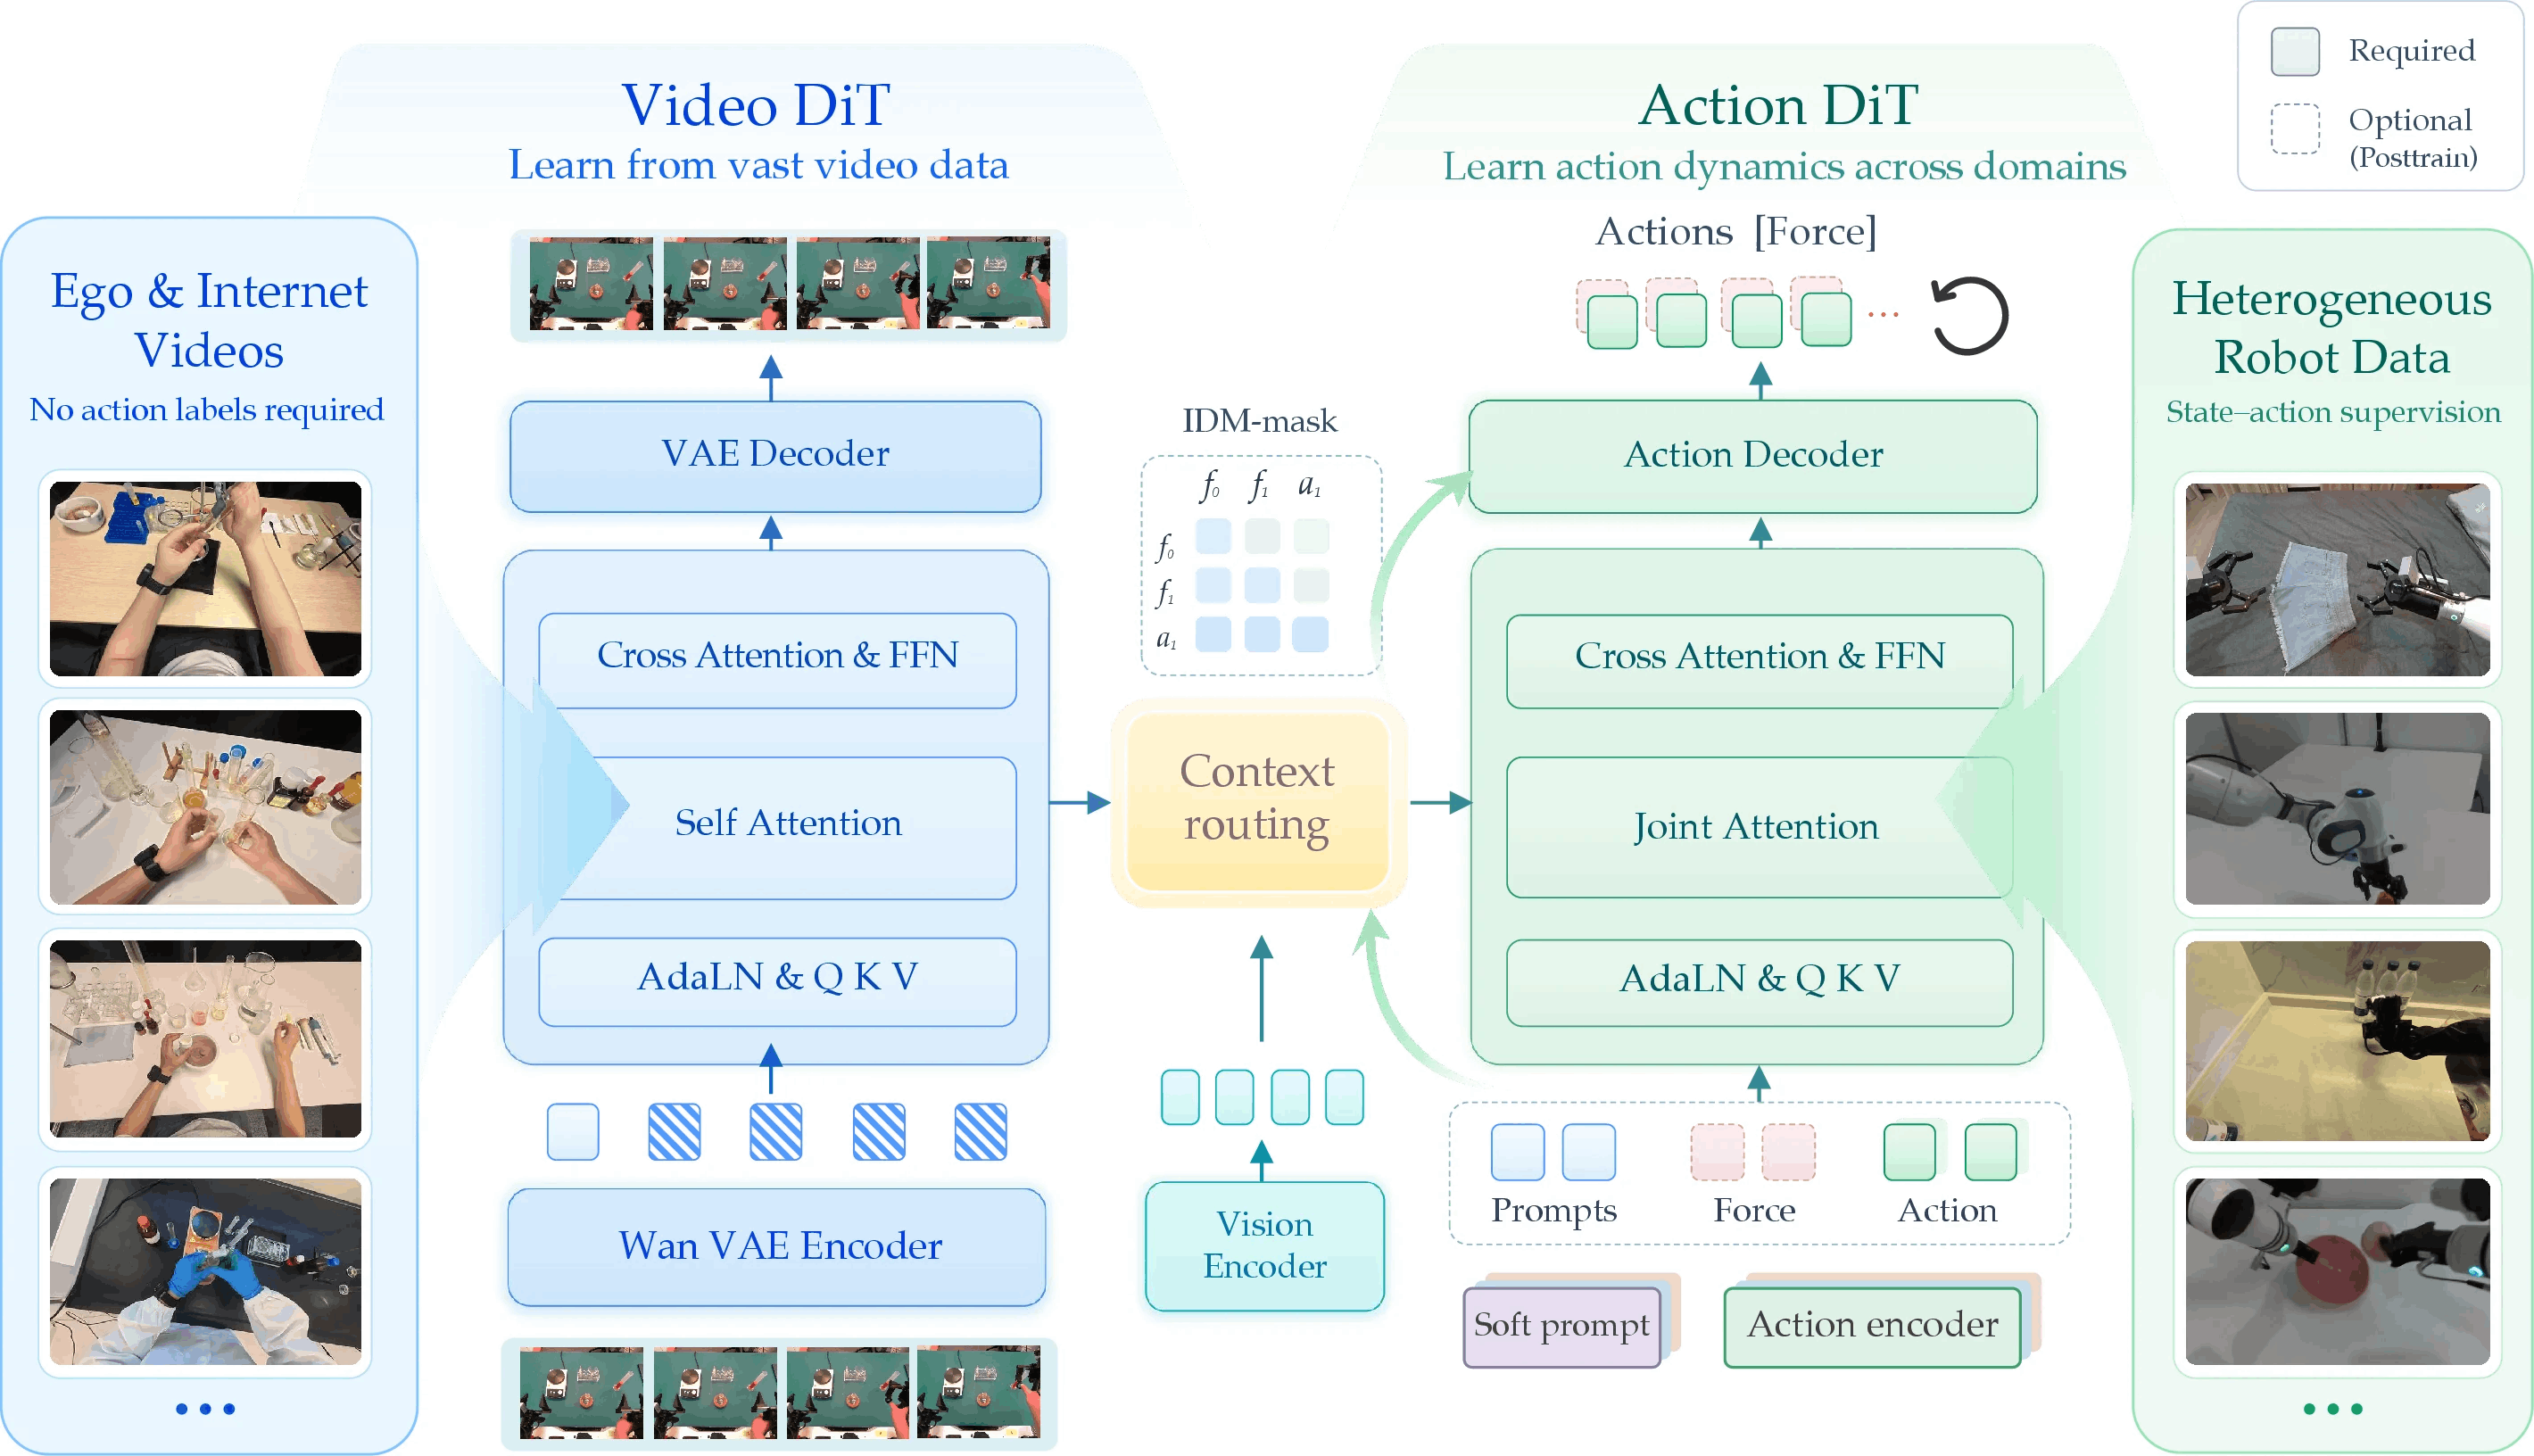
用 AHA-WAM 的方式实现力触觉 reactive,预训练 3000h+ InternData,实现了很好的 C2R.
patchwam (66)
⭐️⭐️ https://www.alphaxiv.org/abs/2609.25961
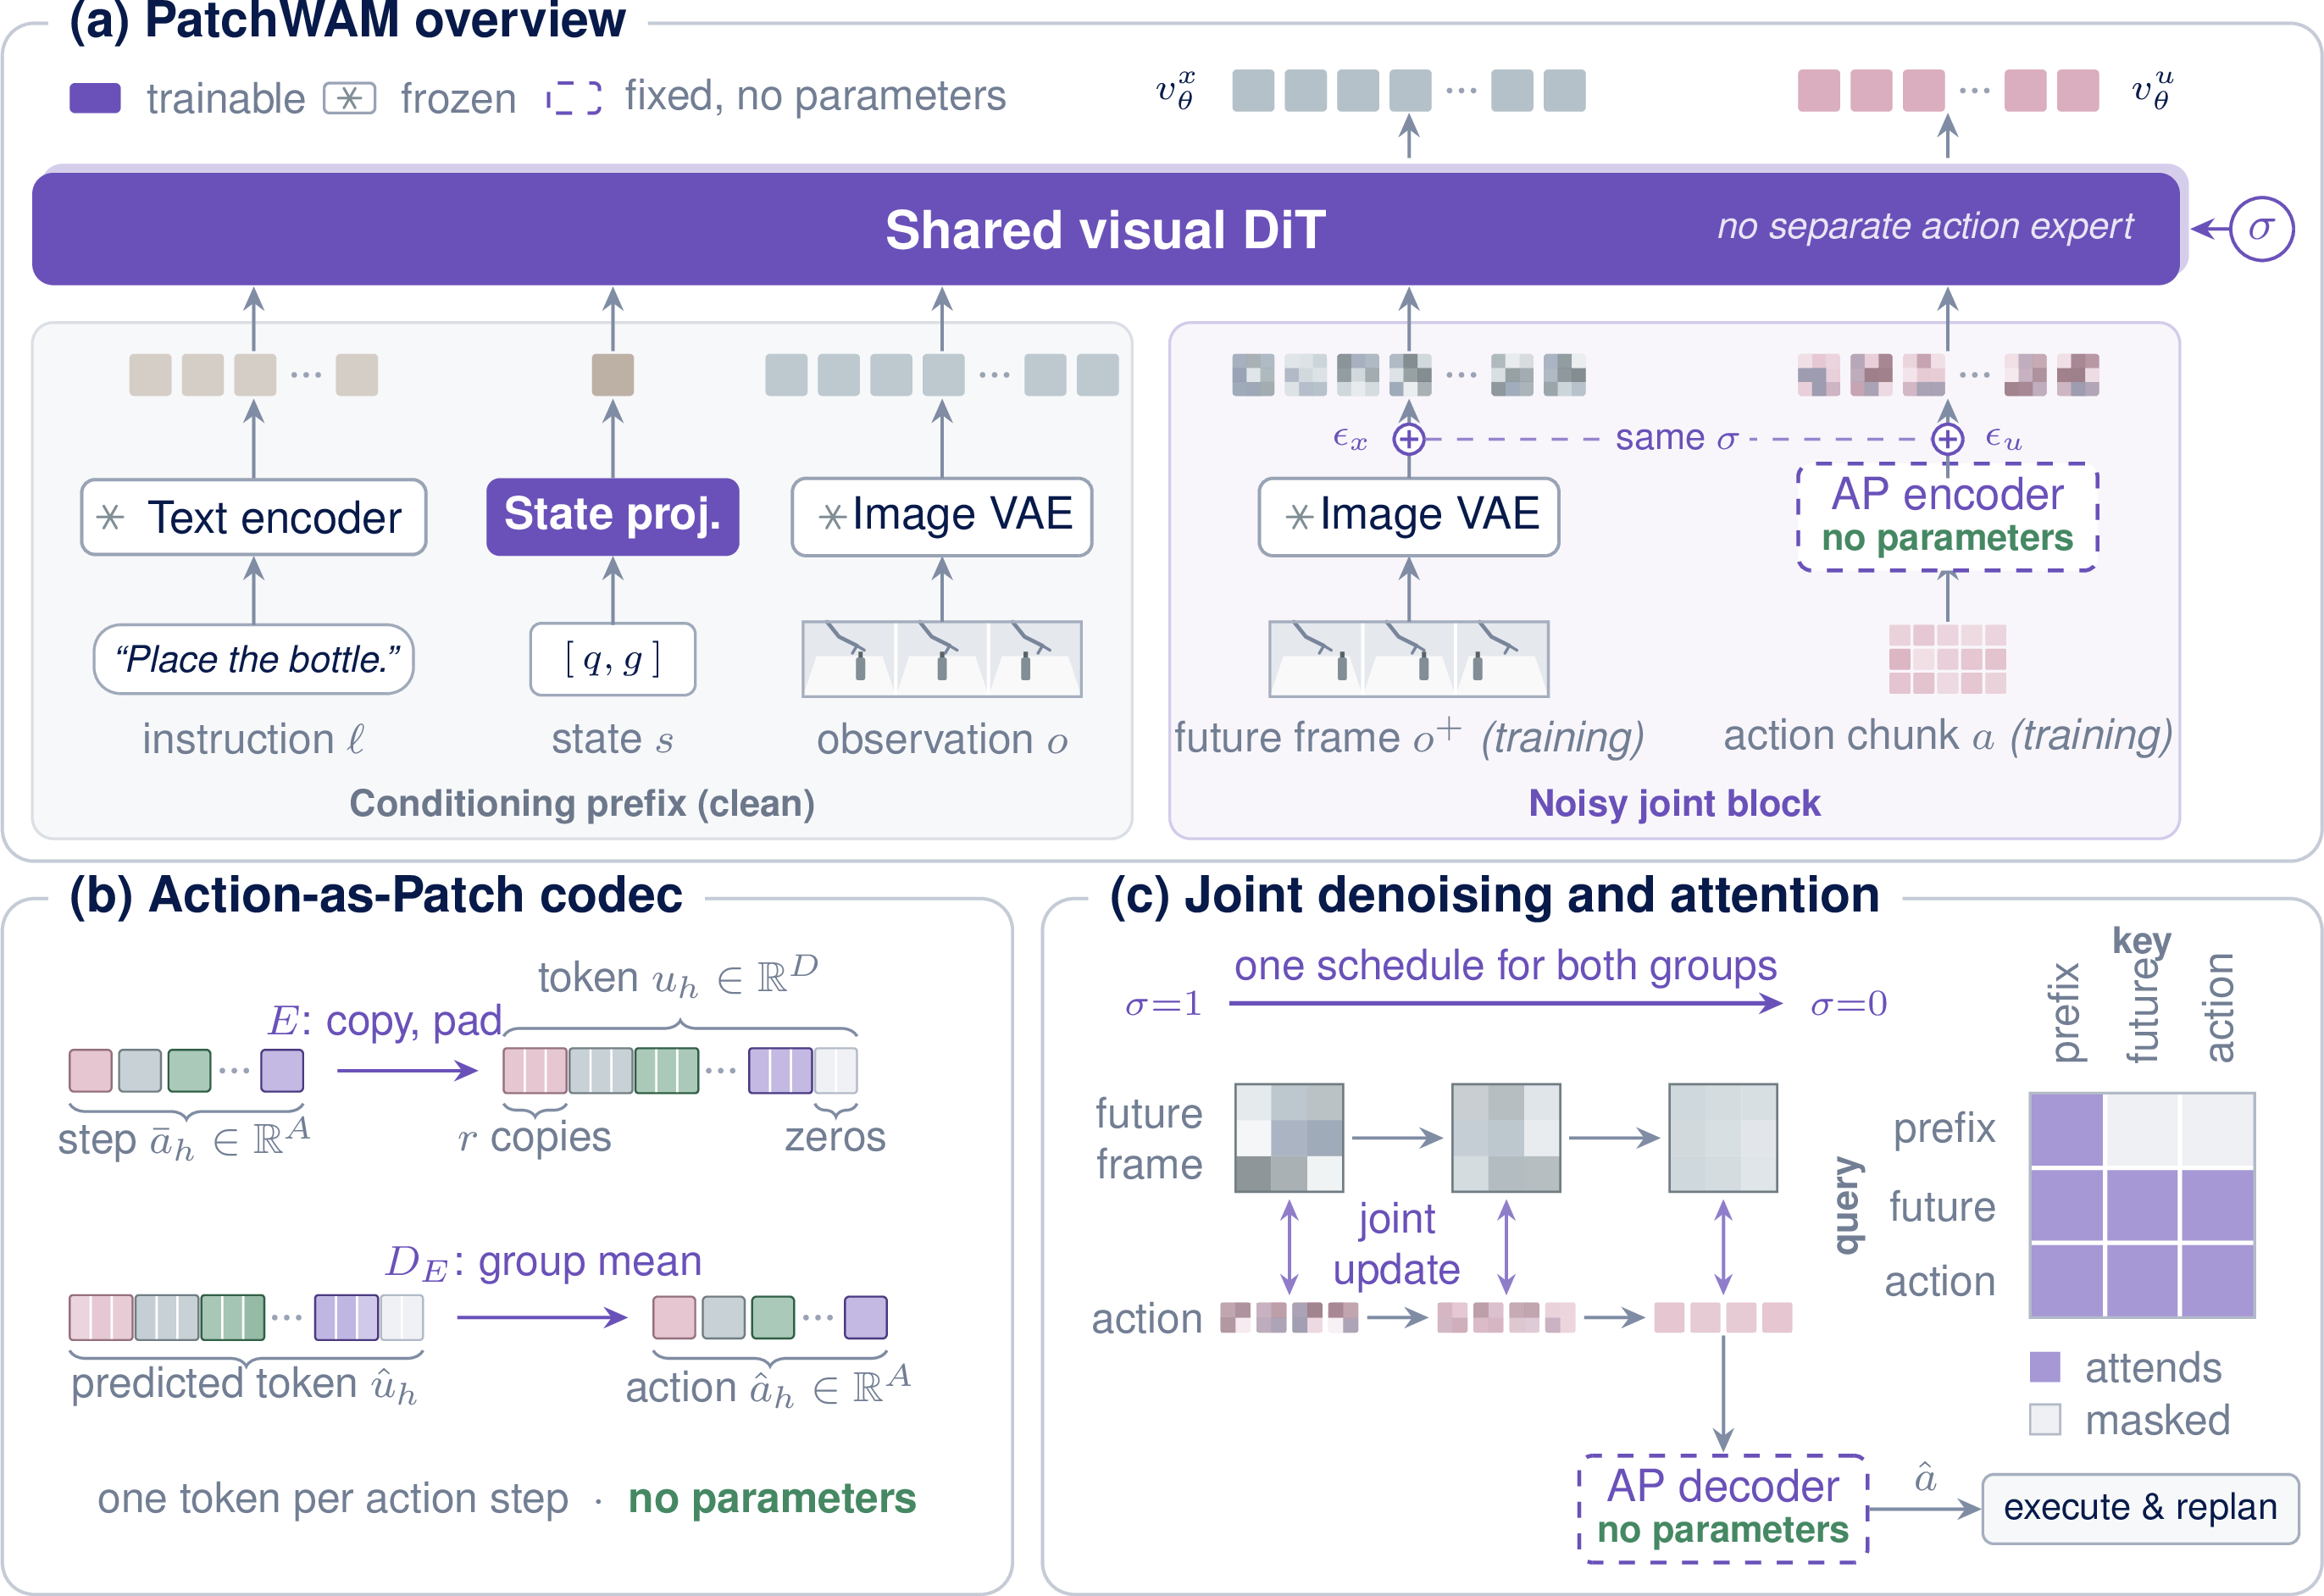
以 FLUX 图像生成模型作为单 backbone,无需预训练,并将 action 直接无学习编码到 image patch 空间进行 image-action 联合去噪,刷到了 C2R 当前最高分 66.72%.
然而,没有做真机实验。而且用了单图像生成模型而非 video model,缺乏动力学先验,而且很难说是 WAM,整个架构感觉怪怪的.
不同的 WAM 架构
--- AI ---
InternVLA-A1.5
deepseek-flash[1m] Unifying Understanding, Latent Foresight, and Action for Compositional Generalization. 用冻结视频模型监督隐空间 foresight token、把动作专家挂在原生 VLM 主干上 | 👤 马浩翔/贾增/庞江淼, 上海人工智能实验室 物理智能团队 | 🌐 | 📃 2607.04988 | ✨ | 📂
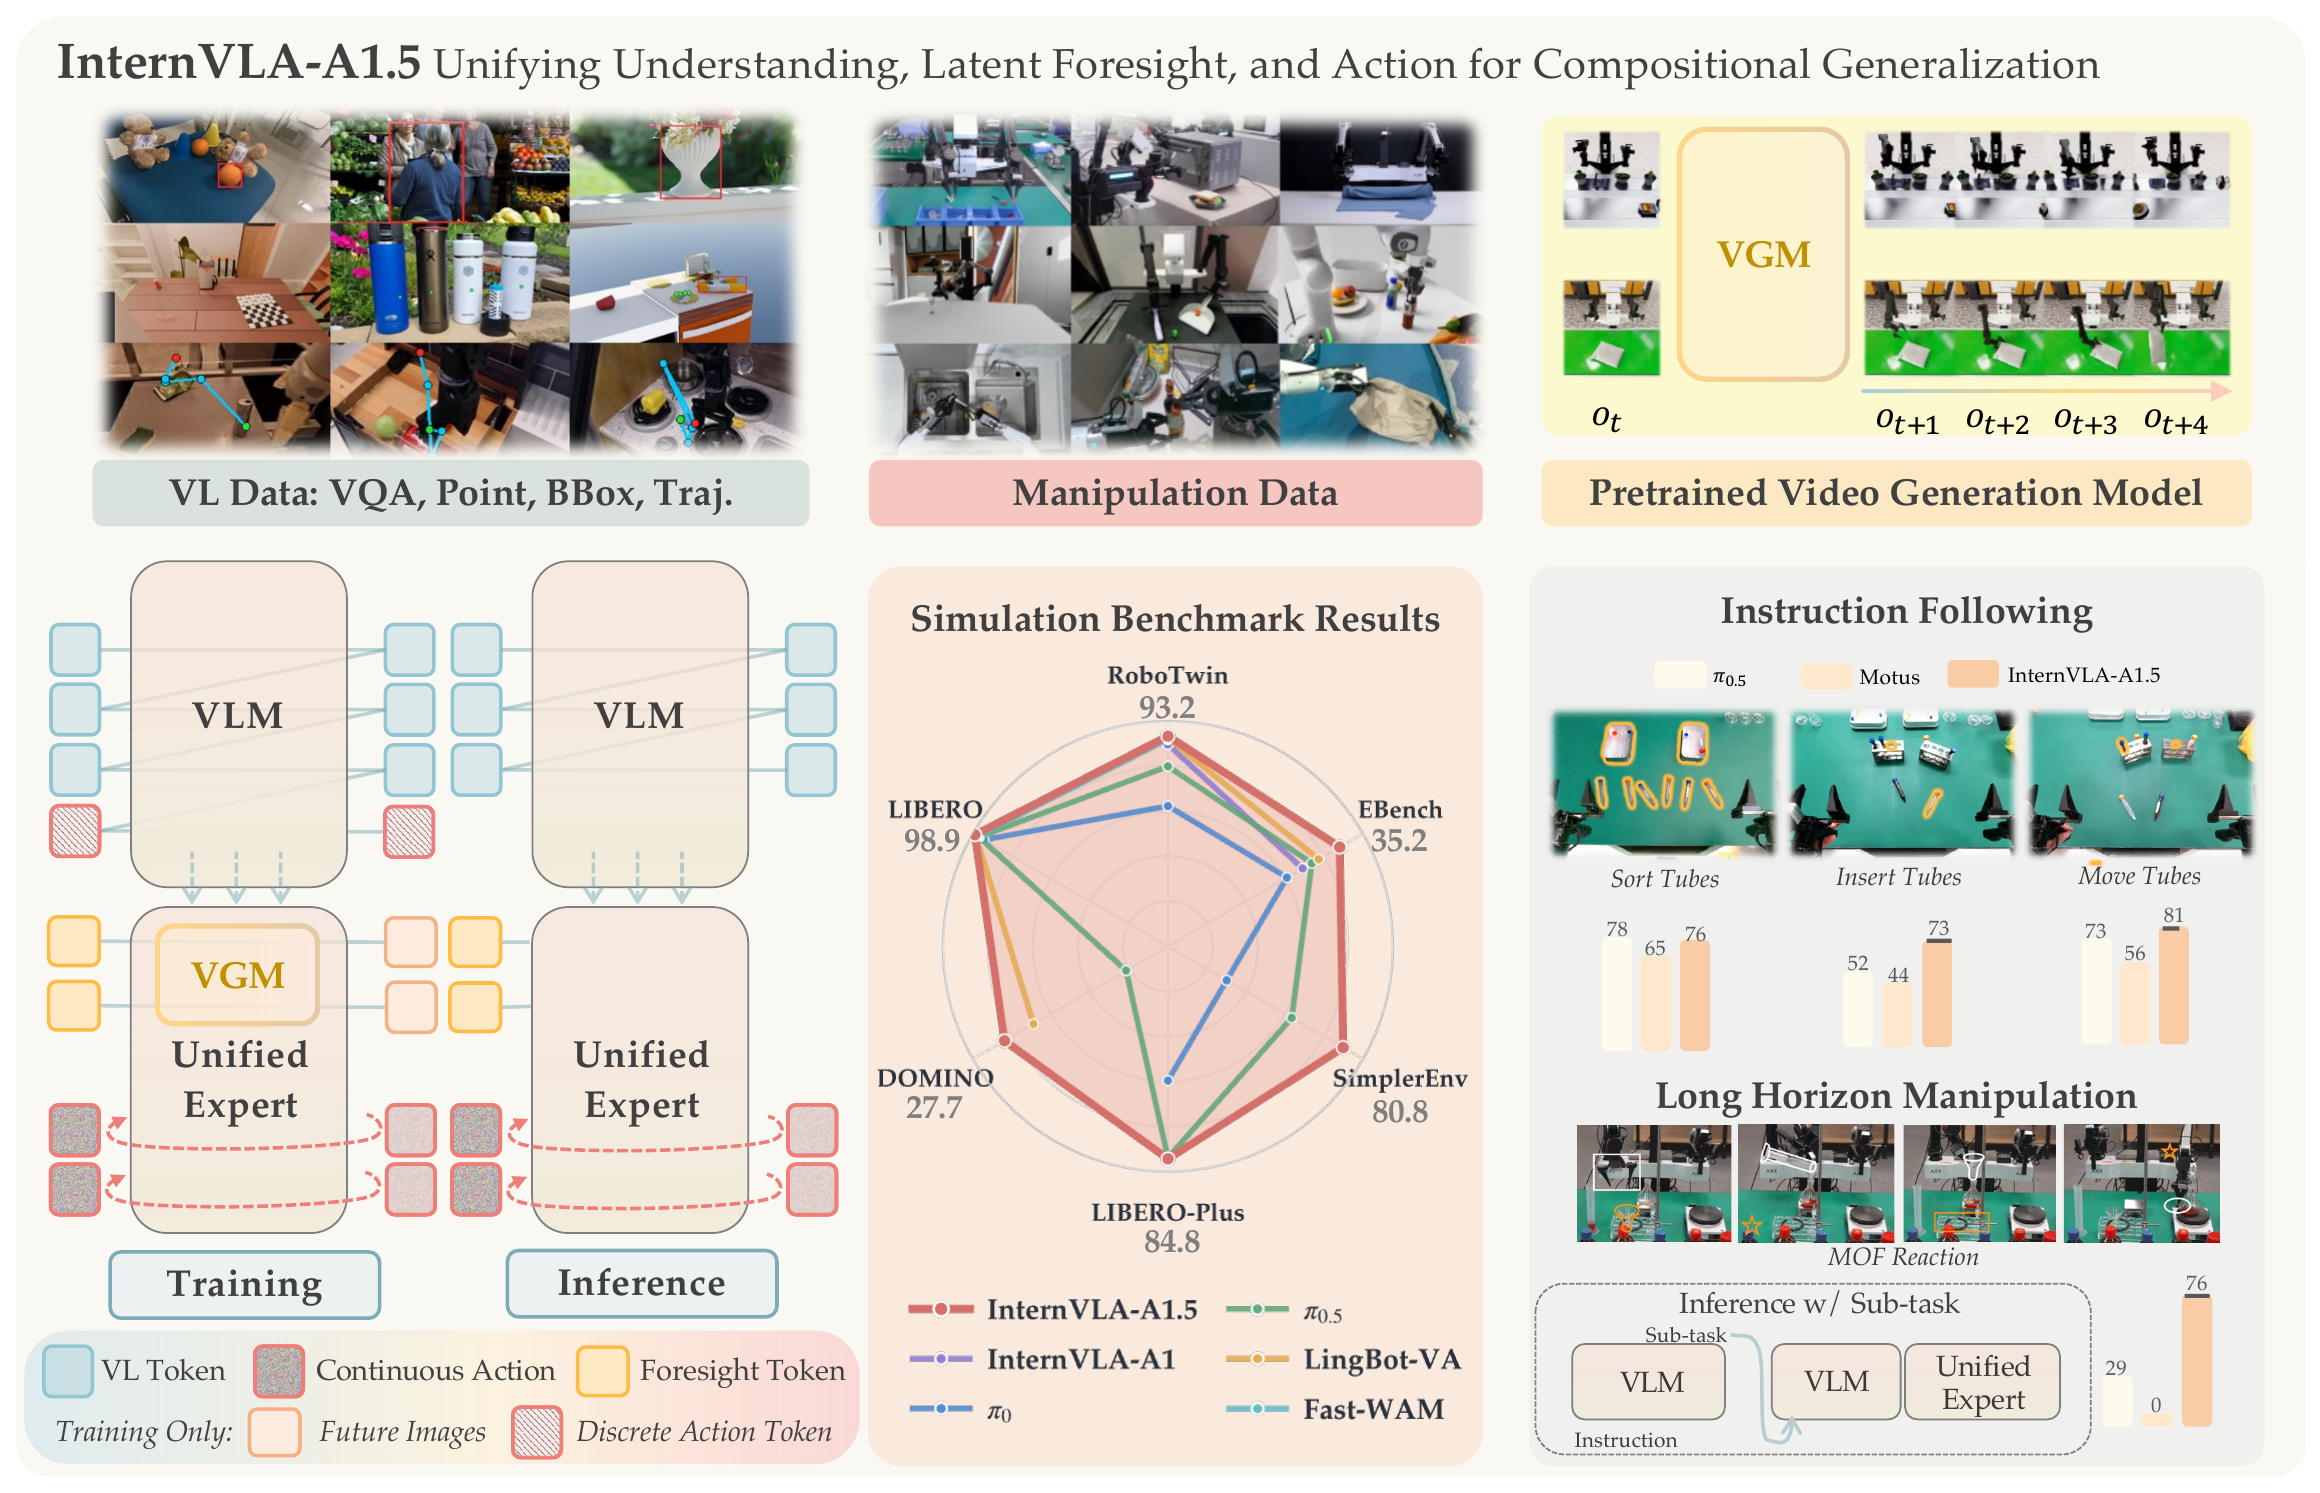
以前的 VLA 要么为了加动作输出把 VLM 主干微调得丢掉了语言语义,要么在像素空间从零训练未来预测、白白浪费预训练视频模型的动力学知识;A1.5 直接拿 Qwen3.5-2B 当主干继续做 VQA 和子任务预测,只挂一个轻量统一动作专家,再让可学习的 foresight token 把未来压成隐空间编码、由冻结的 WAN2.2-5B 监督,推理时丢掉视频分支只走 flow matching,复现用 120 万条机器人 episode 加 300 万多模态样本。
代码放在 InternVLA-A 系列合集仓库里,没有单篇独立 repo,复现要先挑对子目录;另外视频分支只在训练时存在、推理时被丢掉,所以 foresight 到底在推理期还剩多少作用,值得自己实测一下。
GIFT: Guided Intermediate Feature Training via Action-Oriented Structural Supervision for Robotic Manipulation
deepseek-flash[1m] 在策略中间视觉 token 上挂三个只在训练期存在的辅助头做监督 | 👤 中科院自动化所, 郑宇鹏, 张启超/李浩然/赵冬斌 | 🌐 | 📃 2609.04193 | ✨ | 📂 -
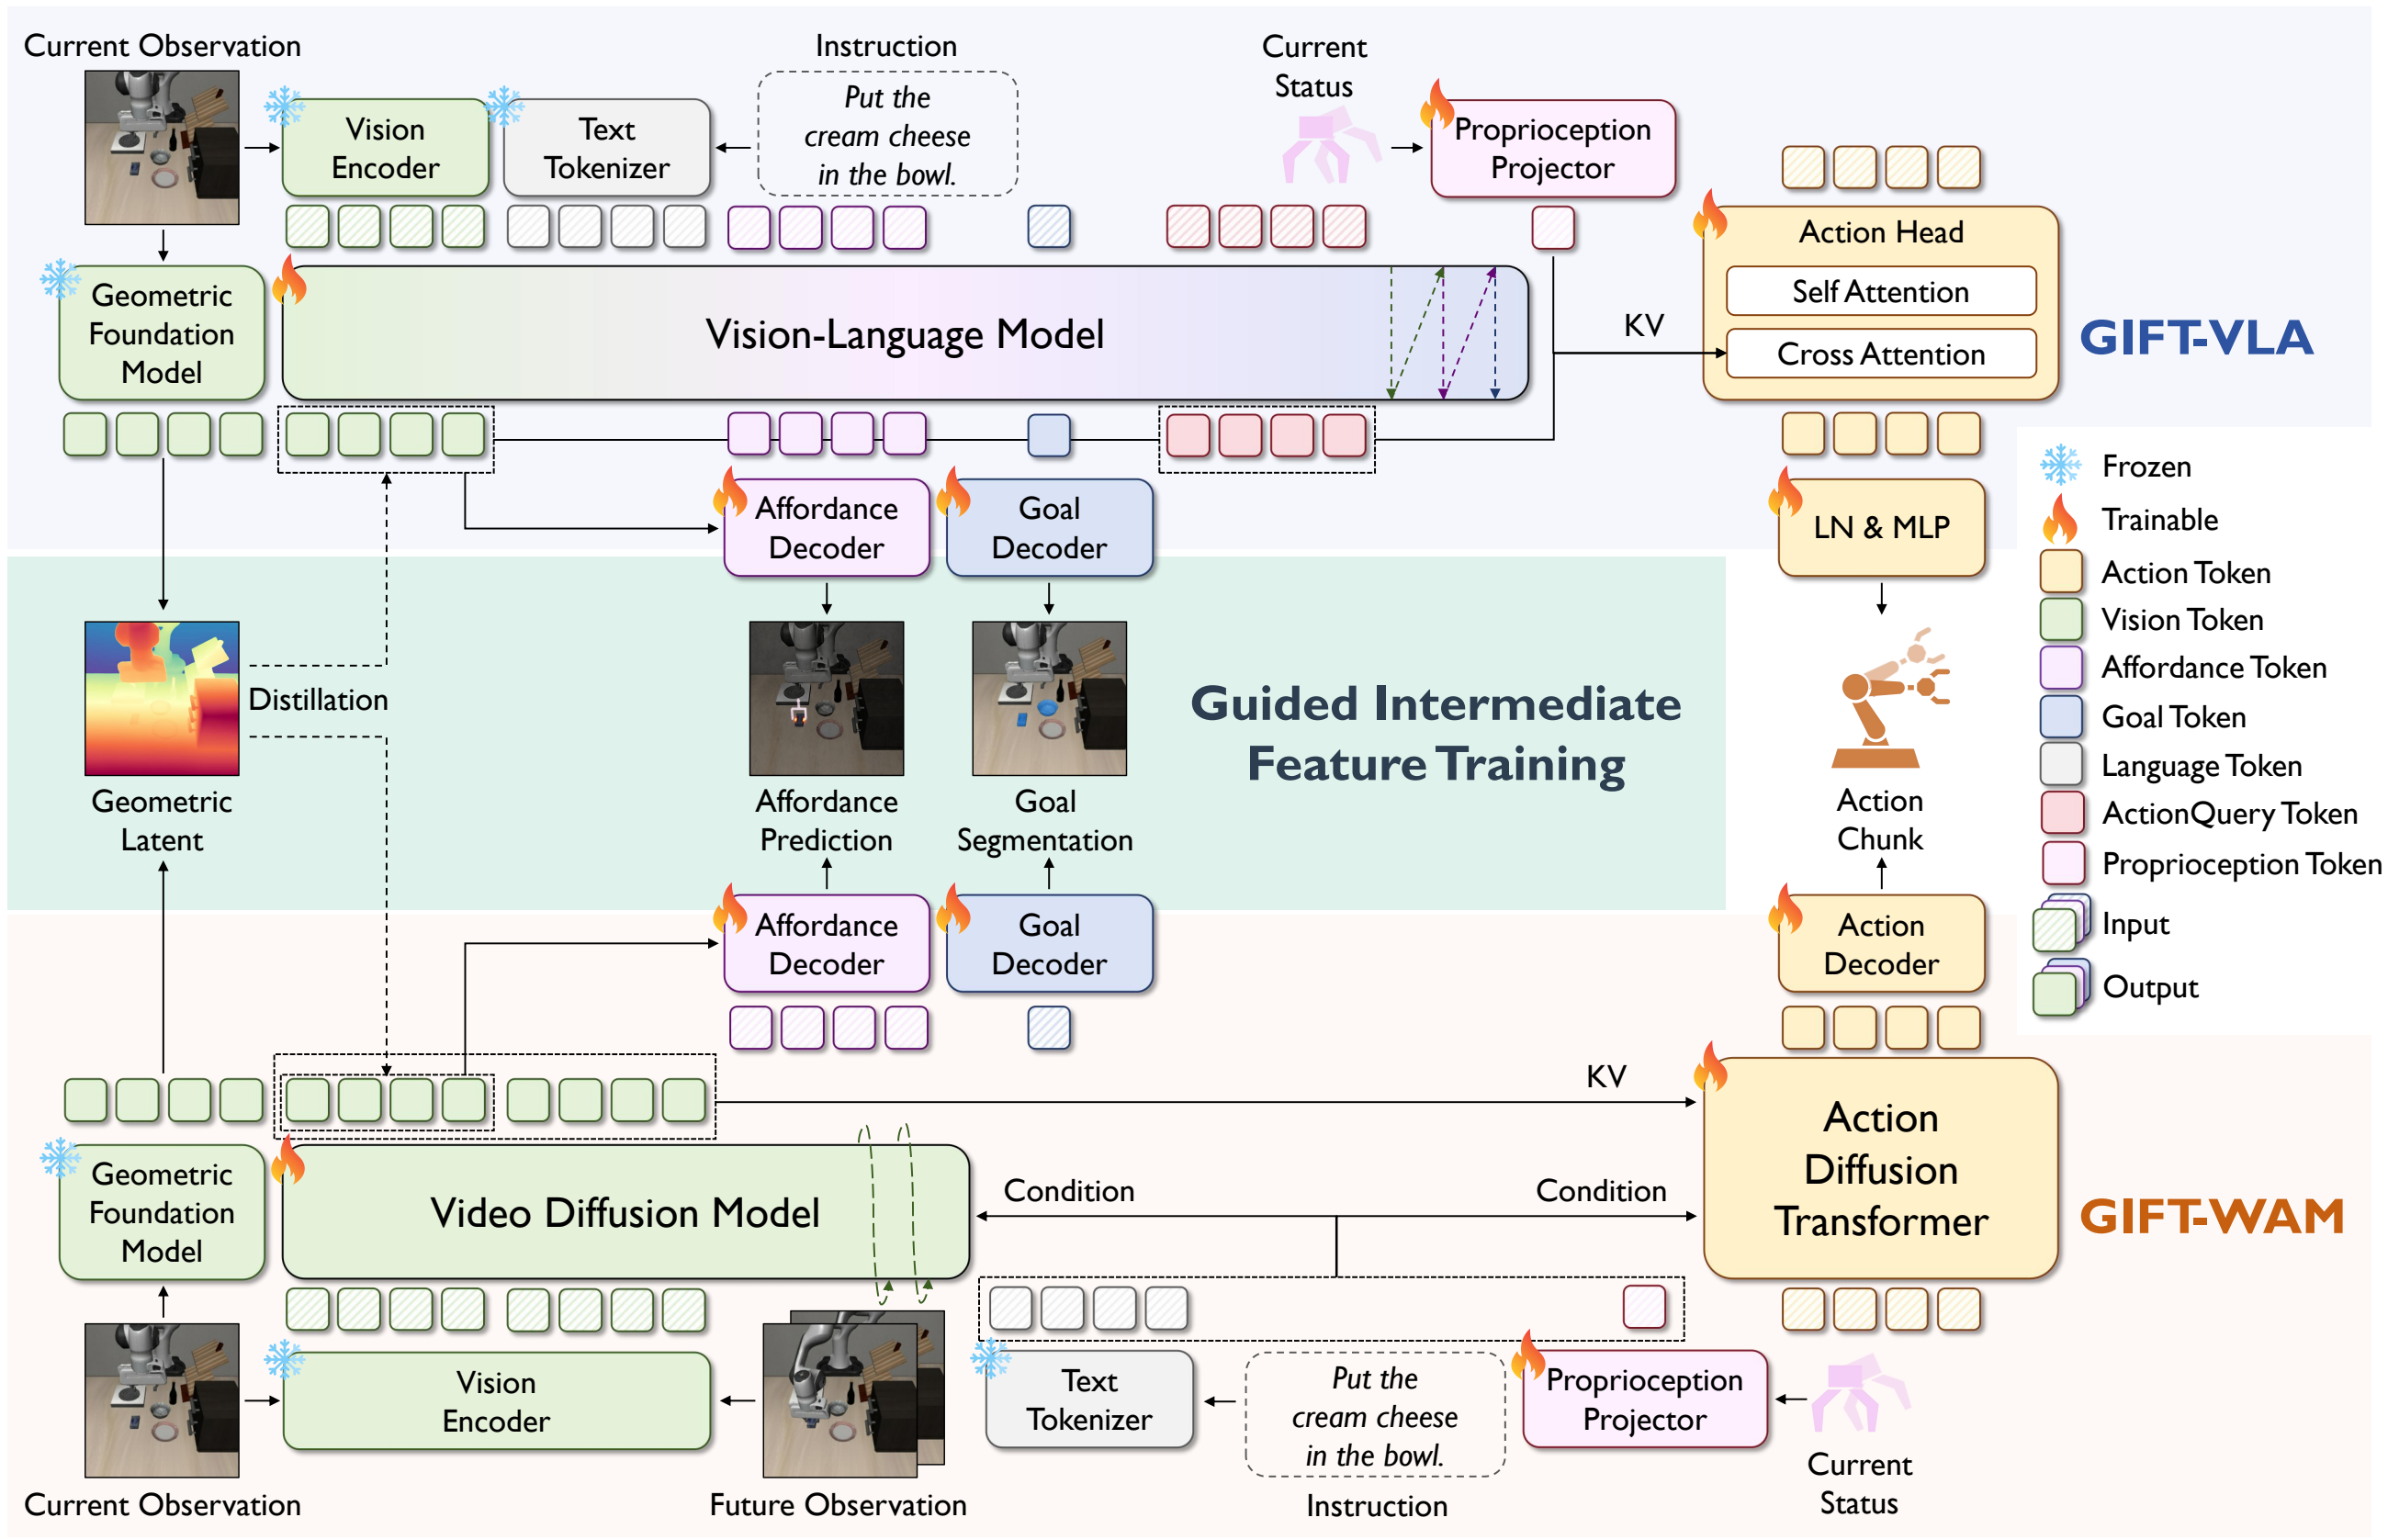
VLA 和世界模型类策略的视觉特征很丰富但原生训练目标不保证中间特征保留控制需要的结构;GIFT 在策略的中间视觉 token 上接三个只在训练期存在的头:几何头从冻结的 VGGT(几何基础模型)向浅层视觉 token 蒸馏方向与尺度,可供性头用 K 个 learnable query 回归 20 维交互目标(角色 ID、物体在锚点物体系下的位姿、末端在物体系下的位姿、夹爪开合);目标头用 goal token 预测任务相关区域的二值掩码并以 BCE 加 Dice 监督。复现只需加这三个头和三组损失、不动主干,推理时把辅助头全部丢掉,也不需要任何额外输入。
三种策略上 GIFT 都可挂:Qwen3-VL 主干加动作查询直接回归的 StarVLA-OFT、视频扩散与动作扩散并行的 Fast-WAM、先想未来再反推动作的逆动力学变体。no-injection(把辅助预测也喂给动作分支)比只用监督的版本更差,说明这批结构信号作为训练梯度有用,作为推理期输入没用。
局限是全部实验都是后训练阶段加辅助监督,没有验证从零预训练是否同样有效;项目页没有放出代码。
Loop the Loopies!
GPT-5.6-Sol 让 Qwen3-MoE 的每个 Attention 和 MoE 层连续执行两次并利用省下的激活内存扩大 microbatch | 👤 IQuest Research, Zitian Gao, Bryan Dai | 🌐 - | 📃 2607.16051 | ✨ | - |
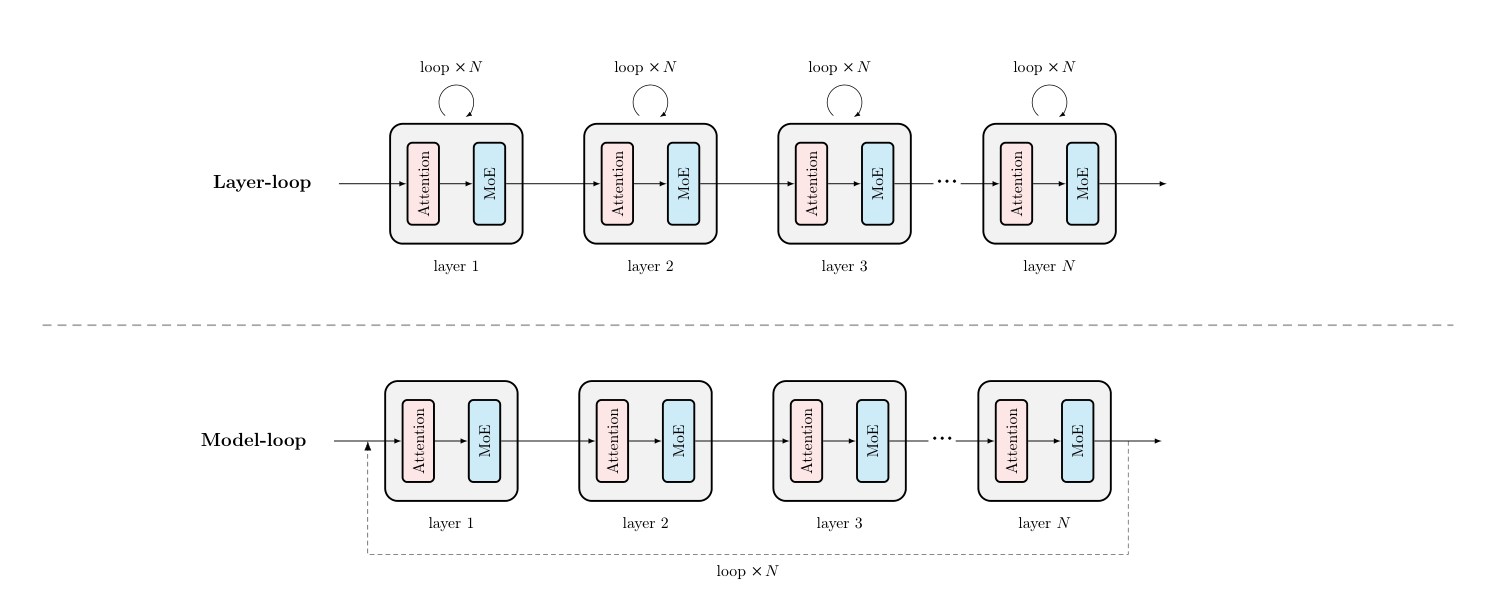
以往 looped Transformer 重复计算后常输给同训练成本的更大普通模型。Loopie 基于 Qwen3-MoE,将每个 Attention 和 MoE 层就地执行两次;27 个存储层由此产生 54 次 block 计算。activation checkpointing 让激活内存随存储层数变化,省下的内存把单卡 microbatch 从 1 提到 2。若要复现则用 Megatron-LM 训练 20B-A2B 或 6B-A0.6B 模型,依次完成 3.5T token 预训练和高质量 annealing、2T token supervised pre-training、数学和代码 GSPO 强化学习;supervised pre-training 采用 128K 上下文和全局 batch 1024并且只对回答 token 计算 loss。
论文只按预训练 wall-clock time 匹配成本,没有系统比较推理成本。主要 post-training 实验集中在数学和代码,supervised pre-training 的消融也不完整。官方 GitHub 链接截至查询时仍为 404,完整训练数据与 checkpoint 可用性因此有限。
Bench2Dex
灵巧手 bench.
OM-1: Frontier Robot Intelligence, Learned Firsthand from Humans
deepseek-flash[1m] 只用人类戴着采集设备干活产生的数据训练一个跨机器人本体的策略,不用遥操作也不用真机数据 | 👤 Reward AI (旧金山湾区, 联创 Zipeng Fu 和 Chen Wang) | 🌐 | 📃 - | ✨ - | 📂 -
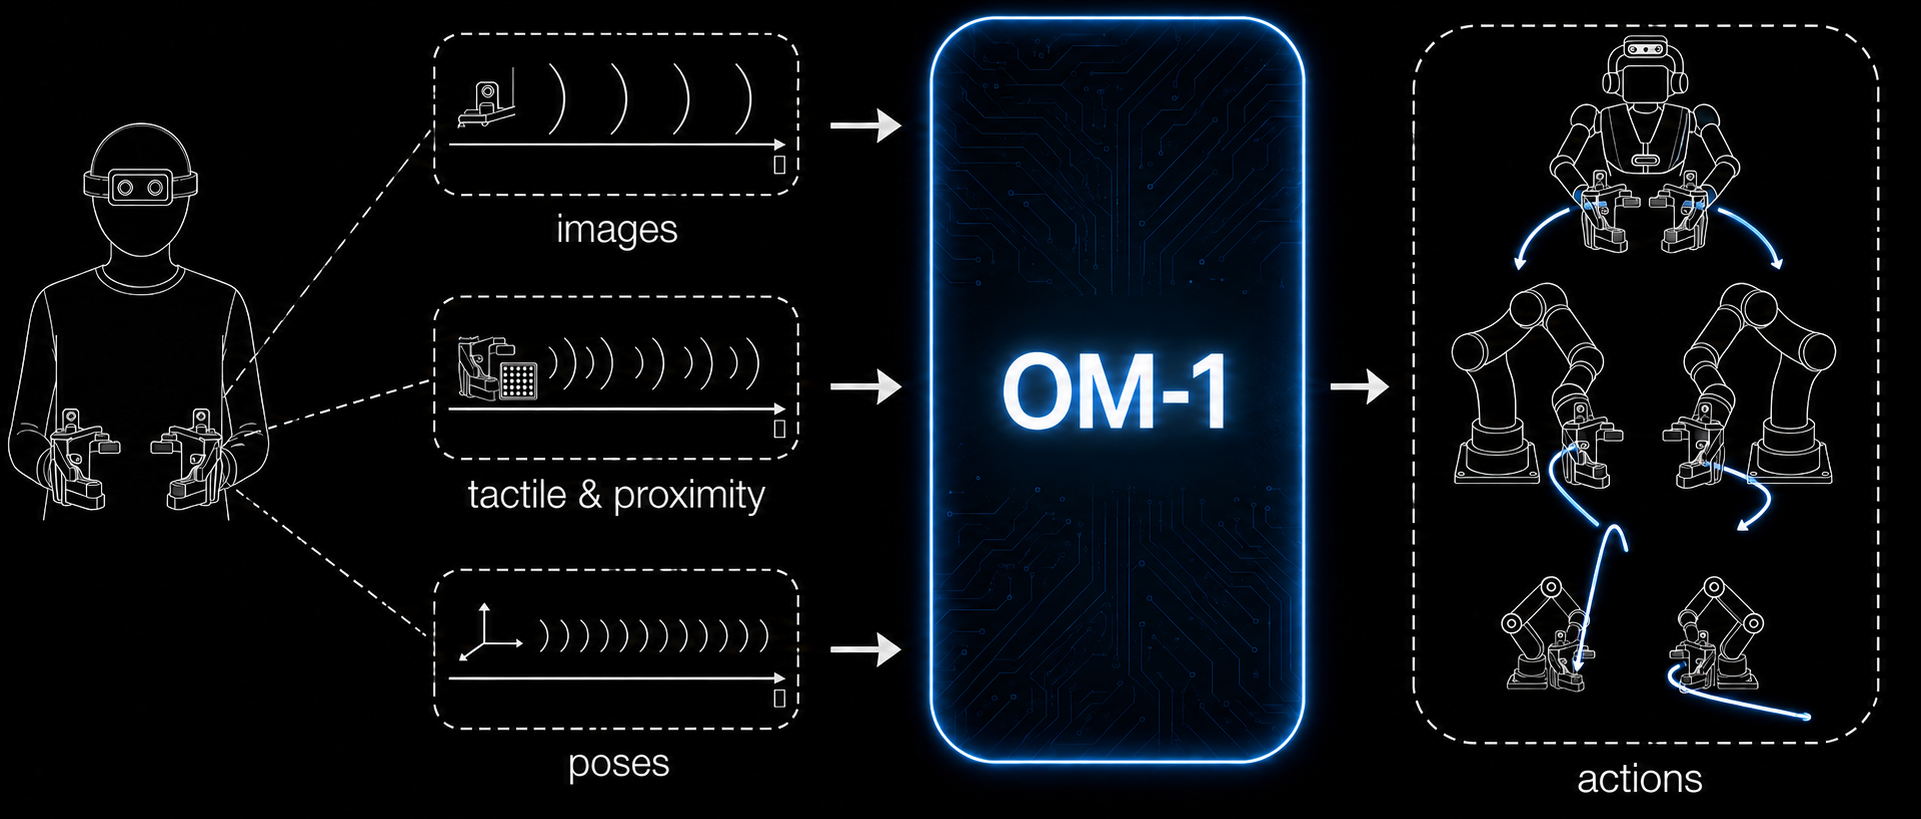
想让机器人有人一样的手部操作效率,采数据的设备就不能逼人改动作。作者沿用自己之前的 DexCap 做了一副 7 自由度的可穿戴 Omnibody Hand,手指不对着人手逐关节复制,只保留捏取、指屈和从精确抓过渡到力量抓这几件事。数据端同时录三路:图像(全局快门手内相机)、接触前的接近感和接触后的触觉与指间接近觉、手臂与手指位姿(视觉惯性再融合电磁跟踪),另外沿同一条轨迹记力。策略 OM-1 是单阶段训练的,最早的演示和最新的演示喂同一个模型,没有单独的预训练和后训练,也不吃遥操作和真机数据。推理时每个模态按它自己传感器的原始频率进网络而不是重采样到统一帧率。输出动作带方向、速度、力和抓取等事件的时机,底下还有个仿真里用 RL 训出来的高频控制层,考虑速度加速度相关的动力学、扰动和延迟,并且跑在自己的时钟上不被策略推理延迟卡住。
没有 arXiv 论文也没有开源代码,架构细节、参数量、损失和超参一概没给,能复现的只有采集端。唯一的定量结果在跟踪上:3 到 67 cm/s 八个速度各跑十次,电磁跟踪的过冲均误差从 0.4 mm 涨到 9.5 mm 而视觉惯性从 2.1 mm 涨到 24.9 mm。任务侧只有一句不到 30 分钟数据学会新任务。没有任务名也没有成功率,也没有和遥操作或真机数据的对照组。
RoboRSI: Stable, Efficient, and Reusable Robot Self-Evolution in Complex Real-World Environments
deepseek-flash[1m] 用 Manager、Planner、Engineer、Reviewer 四个 agent 组成闭环,让机器人自己迭代拆任务改代码并把稳定分支固化成代码技能 | 👤 穹彻智能 Noematrix Team | 🌐 | 📃 - | ✨ - | 📂
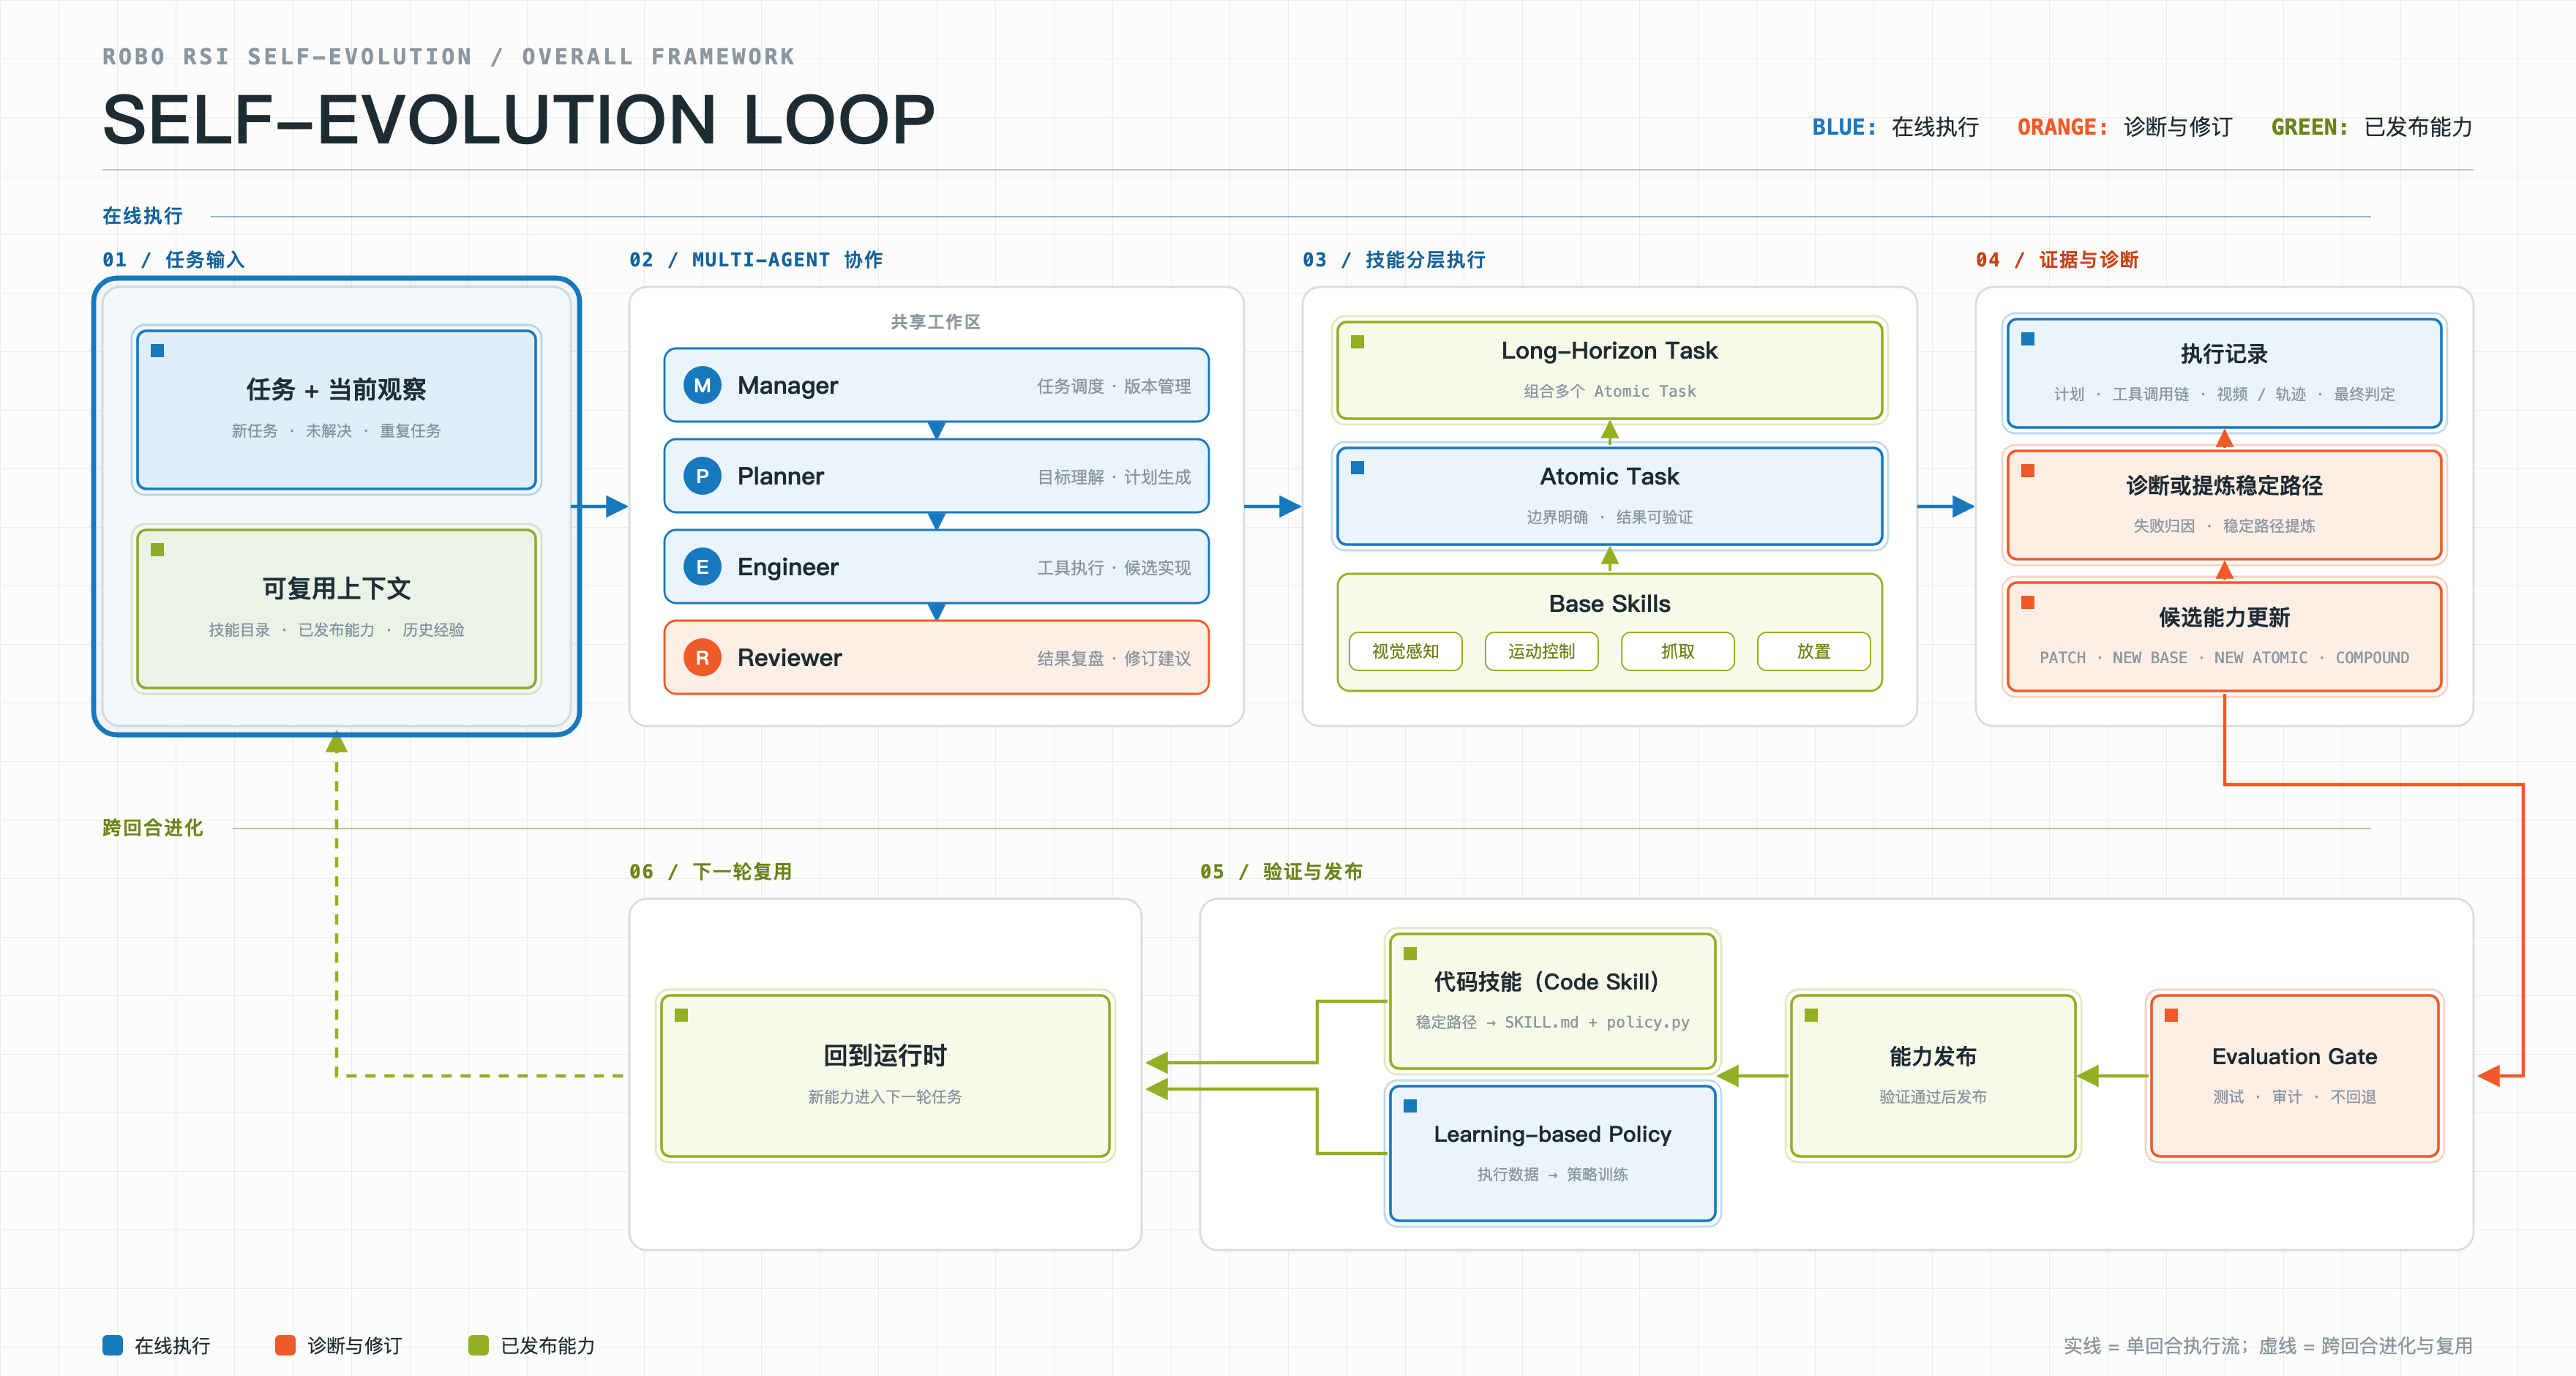
动机是让机器人在真实场景里自己迭代出技能。四个 sub-agent 分工:Manager 维护任务队列、并发 worker、断点与技能版本,Planner 出计划,Engineer 调机器人工具读日志写候选实现,Reviewer 从执行证据里定位最早出错的节点并把修订建议送回 Manager。技能按四层组织成树:最上面是 long_horizon/
主推的通过率都是累计口径(任务在某个 release 里至少通过过一次),不是固定策略的 per-episode 成功率。角色消融里 RoboTwin 上只留 Engineer 是 9/50,加上 Planner 和 Reviewer 到 36/50。开源仓库里 base skill 只带 libero 和 robotwin 两套仿真实现,真机要照 docs/real-robot-tool-spec.md 重写 policy.py。
GE-Act 2.0: Pretraining and Scaling a World-Action Model for Robotic Manipulation
[GPT-6] 单步生成未来视觉 latent 后由逆动力学模型输出动作,联合训练时筛选与示范动作相容的未来预测 | 👤 AgiBot, AgiBot Research Team(首位个人作者 Renhang Liu), Maoqing Yao | 🌐 | 📃 2609.05588 | ✨ | 📂 - |
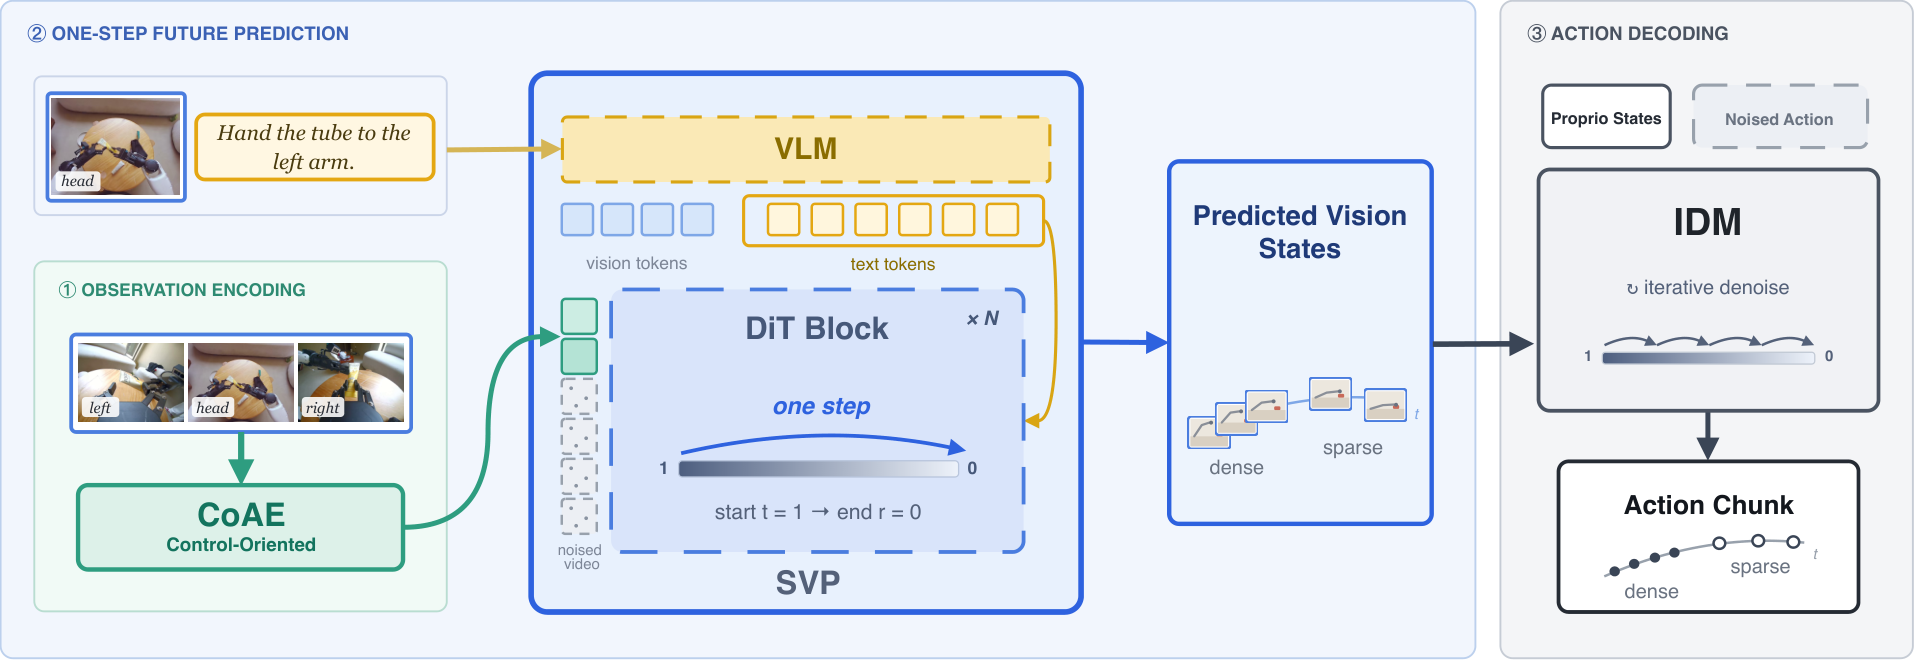
为利用无动作标签的视频和无语言标签的机器人轨迹,本文分别预训练未来视觉生成器和逆动力学模型 IDM。CoAE(基于 DC-AE 的图像自编码器)通过图像重建及三种视觉教师的特征对齐将每帧压成 24 个 512 维 token。冻结的 Qwen3.5-2B 提供图像条件下的文本特征;SVP(采用条件 MeanFlow 的 DiT)一次前向生成未来 latent;IDM 读取当前与未来 latent 及机器人状态后用五步 flow matching 输出关节动作。联合训练的 KASO 每次生成四个候选未来,按 IDM 在候选未来与真实未来条件下的动作速度预测差异选一个进行端到端更新;同时保留真实视频预测和真实视频条件下的动作损失。生成器和 IDM 从随机权重训练;CoAE 继承部分 DC-AE 权重。
真机主实验直接评估预训练模型;仿真实验先做基准内微调再测 OOD。300 至 30000 小时的 scaling 指联合训练阶段,各组此前已共享 39000 小时视频及 32000 小时动作轨迹预训练。顺序指令、部分精细操作和 LIBERO-Plus 背景扰动仍是弱项;项目页代码尚待发布。
RoboTTT: Context Scaling for Robot Policies
[GPT-5] 用测试时更新的 fast weights 压缩 8K 步轨迹并保持固定推理成本 | 👤 NVIDIA、Stanford, Yunfan Jiang, Linxi “Jim” Fan | 🌐 | 📃 2607.15275 | ✨ | 📂 -
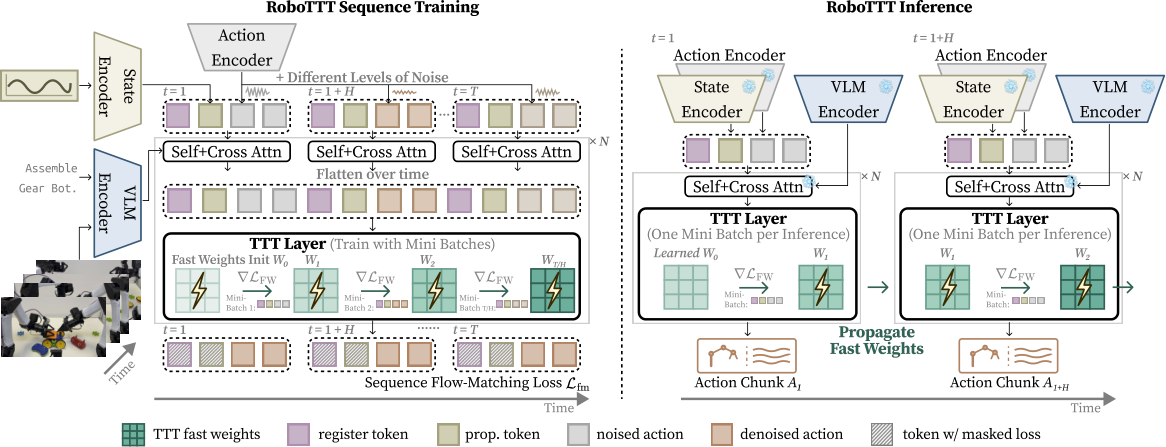
RoboTTT 基于 GR00T N1.7,在 16 个 action DiT layer 的 attention 后各接一个 TTT layer。每层用两层 MLP 作为 fast model 并以自监督损失学习 K→V,再用更新后的 MLP 查询 Q。state、noisy action 和 16 个 register token 跨时间进入 TTT,register token 负责携带 VLM 信息。推理时 slow weights 冻结并将 fast weights 持续传给下一时刻。
训练时为每个 action chunk 独立采样 flow-matching 噪声并使用 TBPTT,避免显存随 8K 步历史增长。预训练使用 16 张 GB200 跑 30K steps,当前未发布代码。
Faster-WAM: Do World Action Models Need Deep Action Modules?
[GPT-5] 将 30 层 WAM action DiT 缩成单层并复用视频骨干各层 KV | 👤 Huawei Noah’s Ark Lab, Liheng Ma, Rui Heng Yang | 🌐 - | 📃 2608.02365 | ✨ | 📂 -
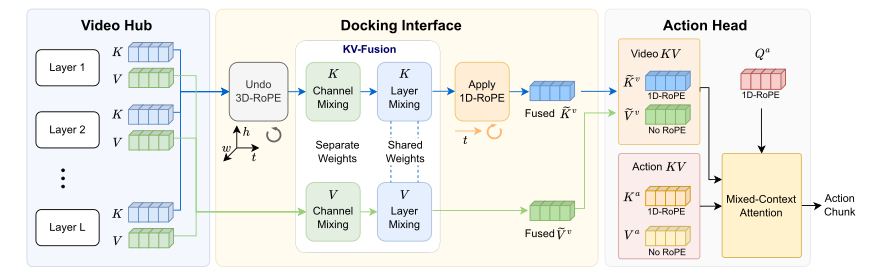
Faster-WAM 使用 30 层 Wan2.2-TI2V-5B 作为视频骨干并缓存每层 KV。KV-Fusion 先把这些 KV 投影到 action feature space,再通过每个 attention head 的可学习权重融合不同视频层。模型随后撤销 video KV 的 3D RoPE 并改用 action query 的 1D RoPE,最后让单层 action DiT 通过 flow matching 生成 32 步 action chunk。训练时联合更新视频骨干、KV-Fusion 和 action head。
它只减少 action 侧计算,完整视频骨干仍需前向运行。实验只有 LIBERO、LIBERO-Plus 和 RoboTwin 2.0 仿真,没有真机验证;论文报告单次 action chunk 推理为 66.5 ms。
BridgeVLA++: A Data-Efficient, Generalizable, and Memory-Augmented Vision-Language-Action Framework for 3D Manipulation
[GPT-5] 在 BridgeVLA 的热图动作预测上加入时空记忆,使策略能利用历史步骤和被遮挡的早期几何 | 👤 中国科学院自动化研究所, Peiyan Li, Yan Huang | 🌐 | 📃 2608.05042 | ✨ | 📂
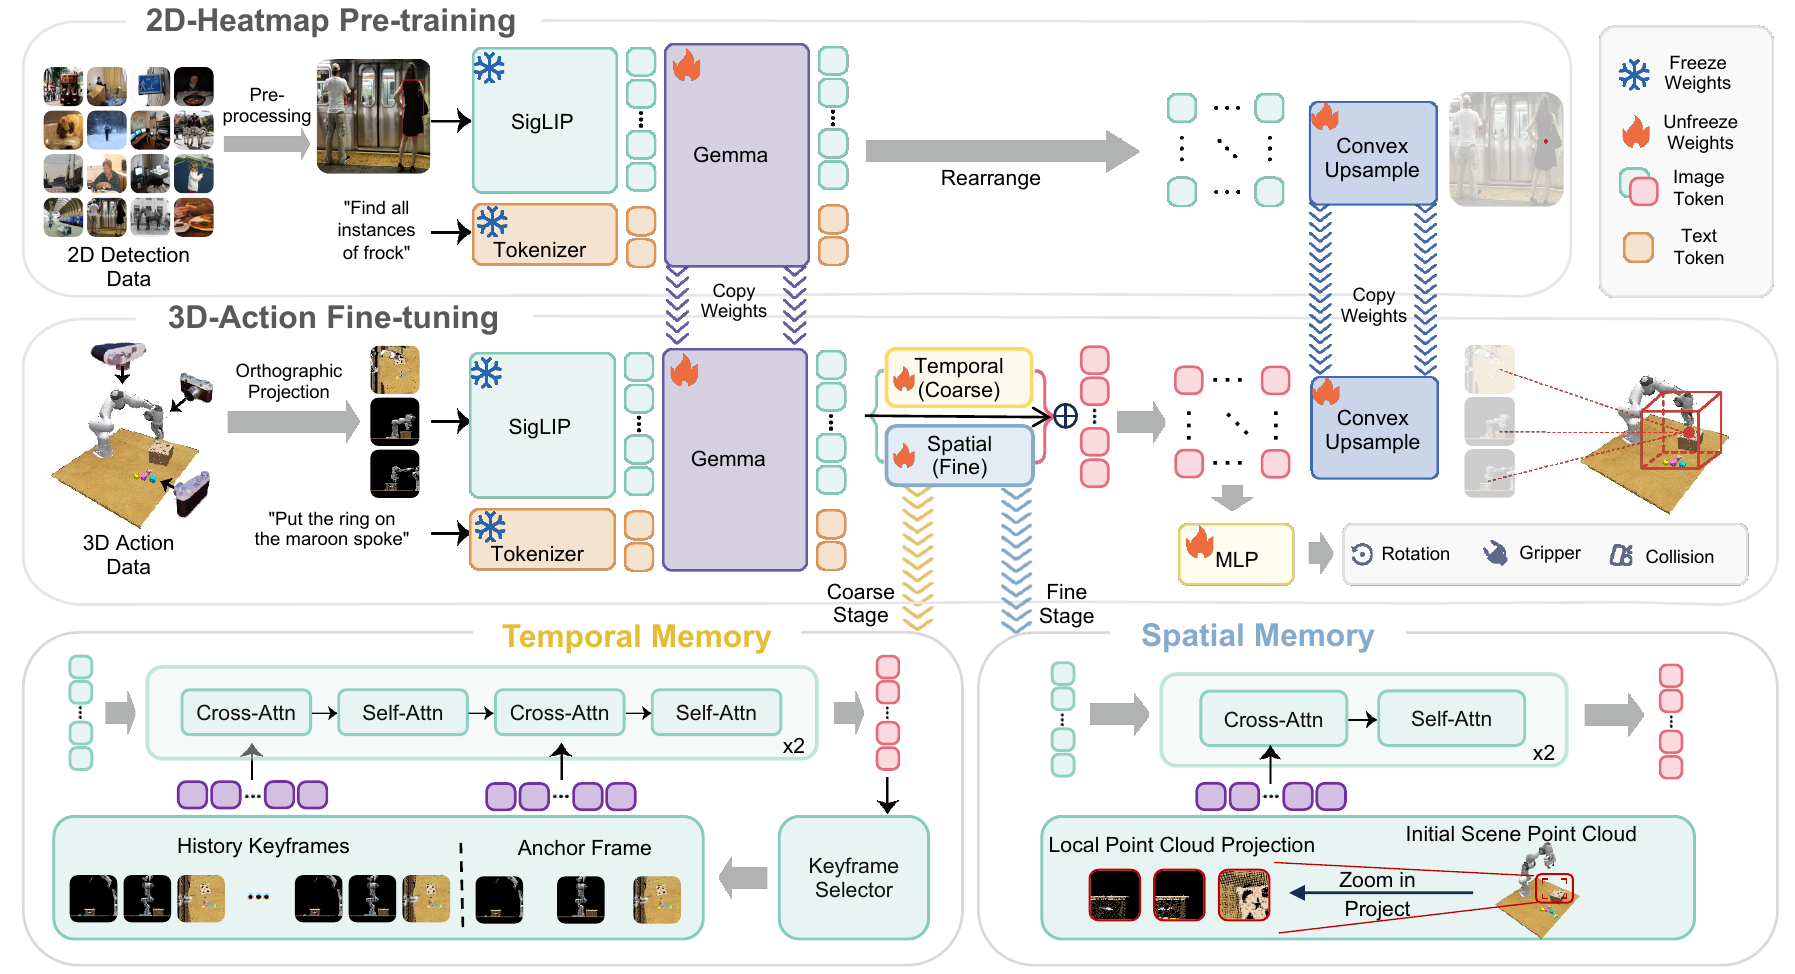
BridgeVLA 先把点云渲染成三个正交视图并让 VLM 预测二维热图,再将热图峰值反投影成三维 waypoint。BridgeVLA++ 在 coarse stage 加入初始帧、最近两个 keyframe 和筛选后的 subgoal keyframe token,用于判断下一步做什么。在 fine stage 保存初始点云并按当前 waypoint 重新裁剪渲染,用较少遮挡的几何辅助精确定位。训练时还用二分类损失监督 subgoal keyframe selector。
历史帧以编码后的视觉 token 缓存,空间记忆则在每个决策步重新渲染初始点云。新增记忆约占 2.7 亿参数并增加推理延迟,subgoal selector 仍依赖人工分段标注。
DROID: A Large-Scale In-the-Wild Robot Manipulation Dataset
[GPT-5] 构建统一硬件和采集协议的多场景机器人操作数据集,并验证其对策略泛化的帮助 | 👤 Stanford University, Alexander Khazatsky, Chelsea Finn | 🌐 | 📃 2403.12945 | ✨ | 📂
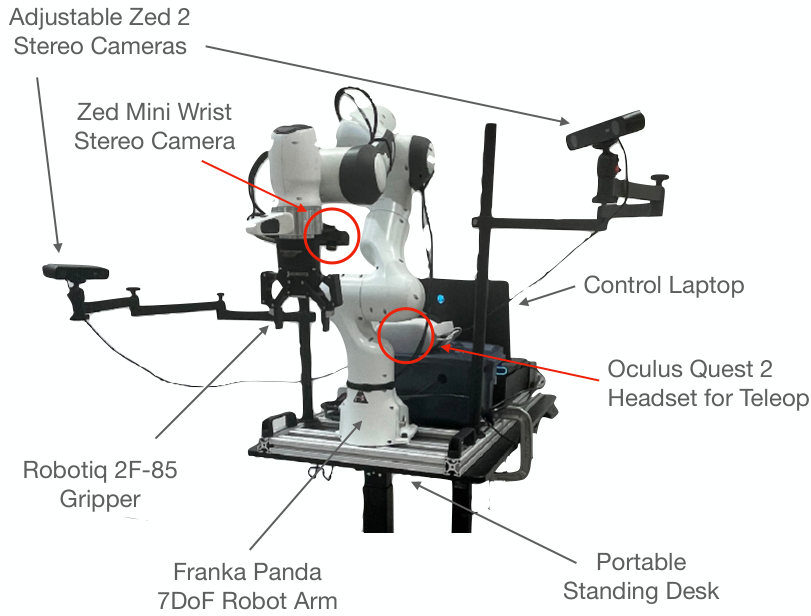
DROID 通过 18 台 Franka Panda、两台可调 Zed 2 立体相机、腕部 Zed Mini 和 Oculus Quest 2 遥操作装置,在 13 个机构的 564 个场景采集 7.6 万条示范。每条数据包含多视角图像、深度、动作、语言指令和相机标定。
若要复现,则搭建同一硬件平台,在新场景中标定相机并随机抽取任务让操作者完成,再用现有 Diffusion Policy 等方法训练,比较加入 DROID 前后的 6 个任务和 4 个地点的常规及分布外表现。
DROID 的贡献主要是数据规模、场景多样性和采集规范,不是新的策略结构。数据统一使用 Franka 形态,且部分自动相机标定在杂乱或视角重叠很少的场景中仍会失败。
CUPID: Curating Data your Robot Loves with Influence Functions
[GPT-5] 用 influence functions 估计每条机器人示范对闭环回报的影响并据此筛选训练数据,支持过滤旧数据和选择新轨迹 | 👤 Stanford University, Christopher Agia, Jeannette Bohg | 🌐 | 📃 2506.19121 | ✨ | 📂
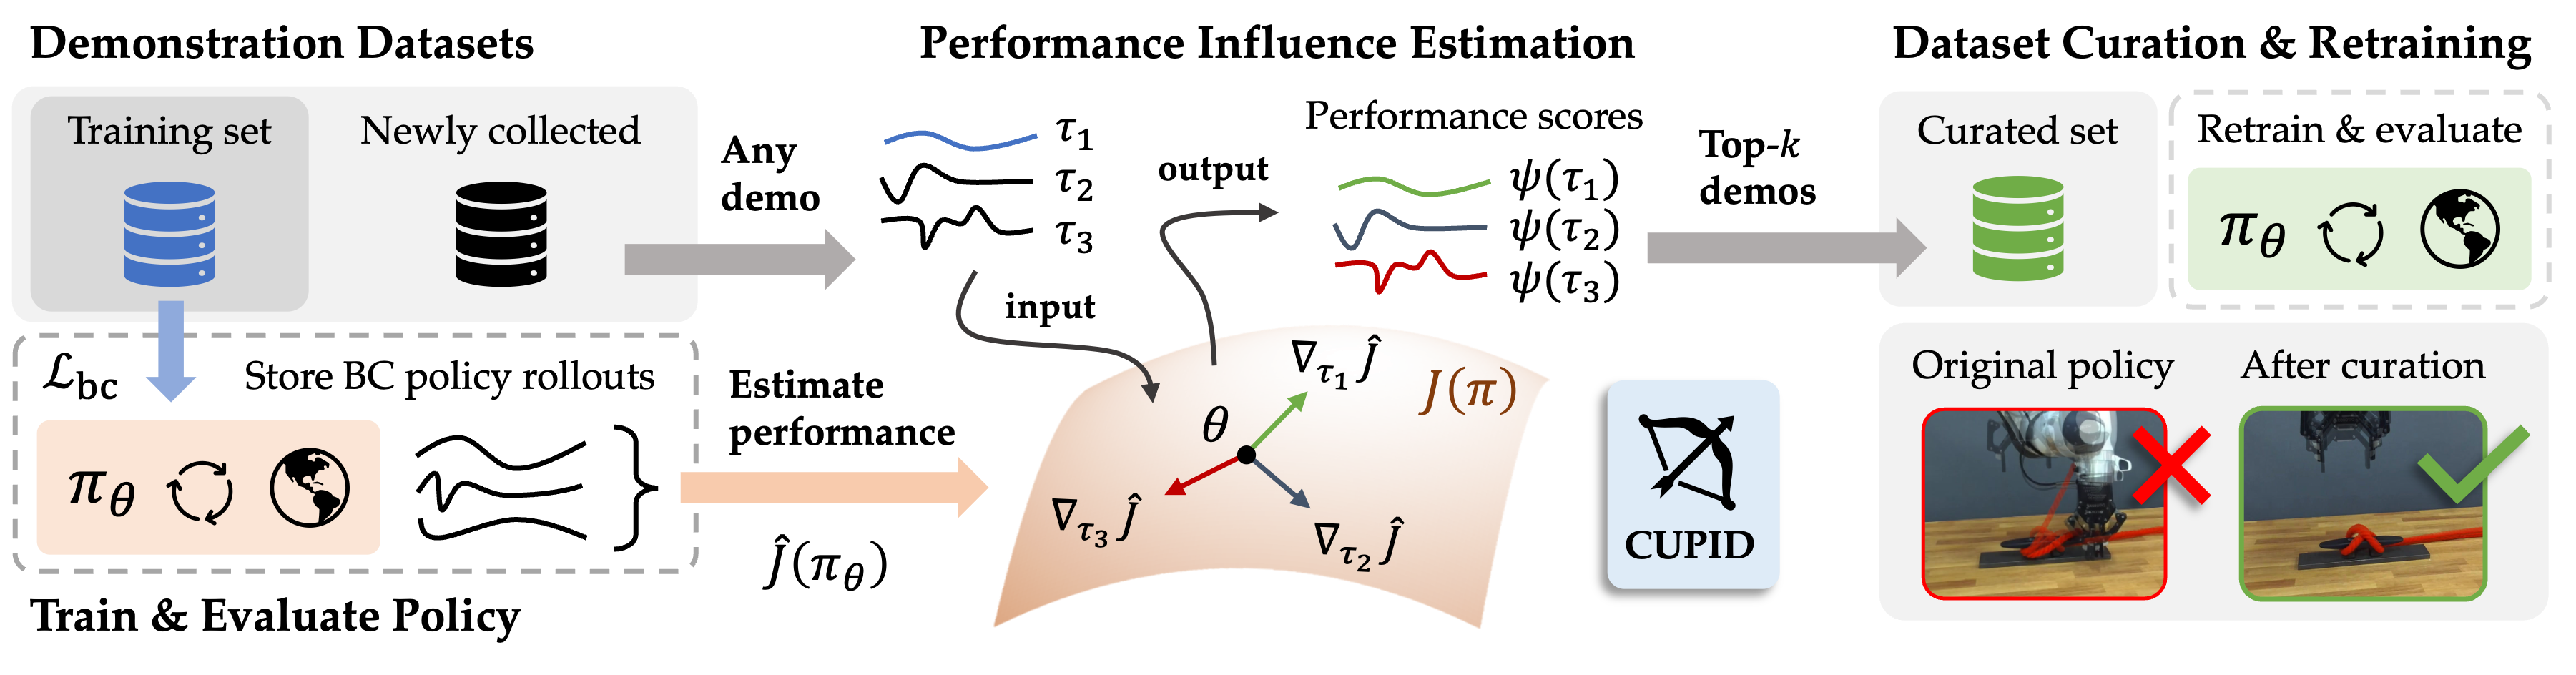
CUPID 先用行为克隆训练 diffusion policy,再收集闭环 rollout 及回报。它用 TRAK 等方法计算训练状态动作对 rollout 动作的 influence,再按 rollout 回报加权汇总成每条示范的 performance influence。过滤任务删除负面影响最大的示范,选择任务保留正面影响最大的示范,最后重新训练策略。代码仓库提供训练、评估、influence 计算、生成筛选配置和重训四阶段流程。
实验覆盖 RoboMimic 和 Franka 真机任务,CUPID 能识别低质量示范、分布偏移下的脆弱策略和背景诱导的伪相关。主要限制是 influence 计算成本接近一次策略训练,rollout 数量过少时 REINFORCE 风格估计方差较大。
ATHENA: Accelerated Multi-Task Heterogeneous Influence Functions for Robot Data Curation
[GPT-5] 用闭环 rollout 的 influence function 给多任务 VLA 示范排序,再保留高价值子集进行联合微调 | 👤 Tongji University, Tao Xu, Yong-Lu Li | 🌐 | 📃 2606.16208 | ✨ | 📂 -
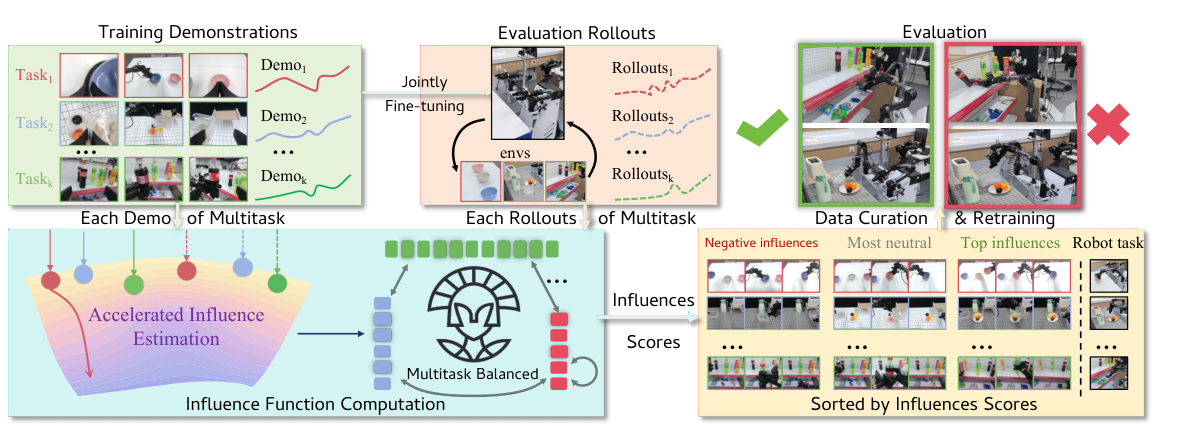
论文要把 CUPID 一类 influence function 数据筛选扩展到 3.3B 参数的多任务 VLA。复现时先微调 并执行带成功或失败标签的闭环 rollout;对训练样本计算 flow-matching loss gradient,对 rollout action 计算 square-flow surrogate gradient;利用线性层梯度 的 Kronecker 结构分别投影 activation 和 backpropagated error,避免构造完整参数梯度;再对投影梯度矩阵做 rank- Random Truncated Approximation,用低维近似代替稠密 Hessian inversion,最后聚合 timestep influence 得到每条 demonstration 的分数。
多任务筛选使用 Multitask Influence Interaction,分别计算 demonstration 对自身任务的 local influence 和对其他任务的 cross-task influence,将二者按任务内排名归一化后相乘。若直接使用全局 influence 排名,梯度较强的任务会占据保留数据,部分任务可能几乎被删空。
ATHENA 面向 VLA fine-tuning data curation,没有验证预训练数据筛选。方法仍需要为每个任务执行真实机器人 rollout,任务数量扩大后数据采集成本较高;低秩 Hessian 和一阶 influence 也只是局部近似。论文在 RoboTwin 2.0 的 50 个任务及 6 个真机任务上验证,使用一半到三分之二的数据可达到或超过全量联合微调。
RL-100: Performant Robotic Manipulation with Real-World Reinforcement Learning
[GPT-5] 从 Diffusion Policy 开始做迭代离线和在线 PPO,再用一致性蒸馏得到单步控制器 | 👤 Shanghai Qizhi Institute, Kun Lei, Huazhe Xu | 🌐 | 📃 2510.14830 | ✨ | 📂
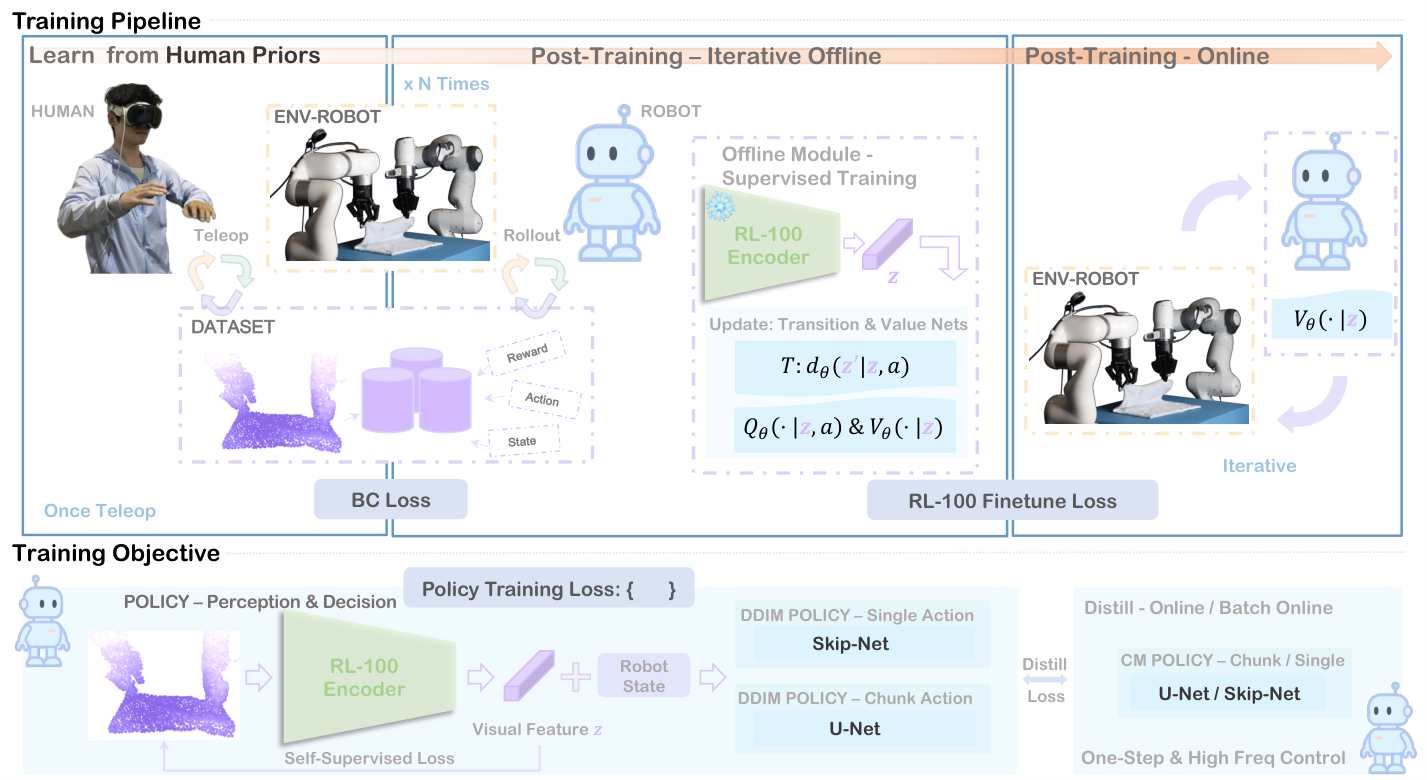
论文要把依赖人类示范的 Diffusion Policy 继续优化到稳定真机部署。复现时先用 teleop 数据训练 Diffusion Policy,再在每个环境动作内部的 K 个 denoising step 上共享同一个 advantage 并计算 clipped PPO loss;离线阶段用 IQL 训练 Q 和 V,以 AM-Q OPE 只接受估计性能提升的 policy,部署新 policy 采集 rollout 后合并回数据集并重新做 imitation learning,最后用 GAE 做少量 on-policy fine-tuning。训练期间同步加入 consistency distillation loss,将多步 diffusion teacher 压成单步 consistency policy。
主要代价是每个任务仍需明确 reward、真实机器人 rollout、reset 和安全监控。100% 来自论文任务设定和有限评测次数,不能直接推为开放环境中的通用可靠性;单步 consistency policy 对噪声和动作不连续更敏感。
Robust-WAM: Bridging Generative Pretraining and Semantic Foresight in World-Action Models
[GPT-5] 保留预训练 WAM 的视频生成路径,用未来帧的 DINOv3 语义监督动作流 | 👤 The Hong Kong University of Science and Technology (Guangzhou), Haodong Yan, Haoang Li | 🌐 | 📃 2608.05903 | ✨ | 📂
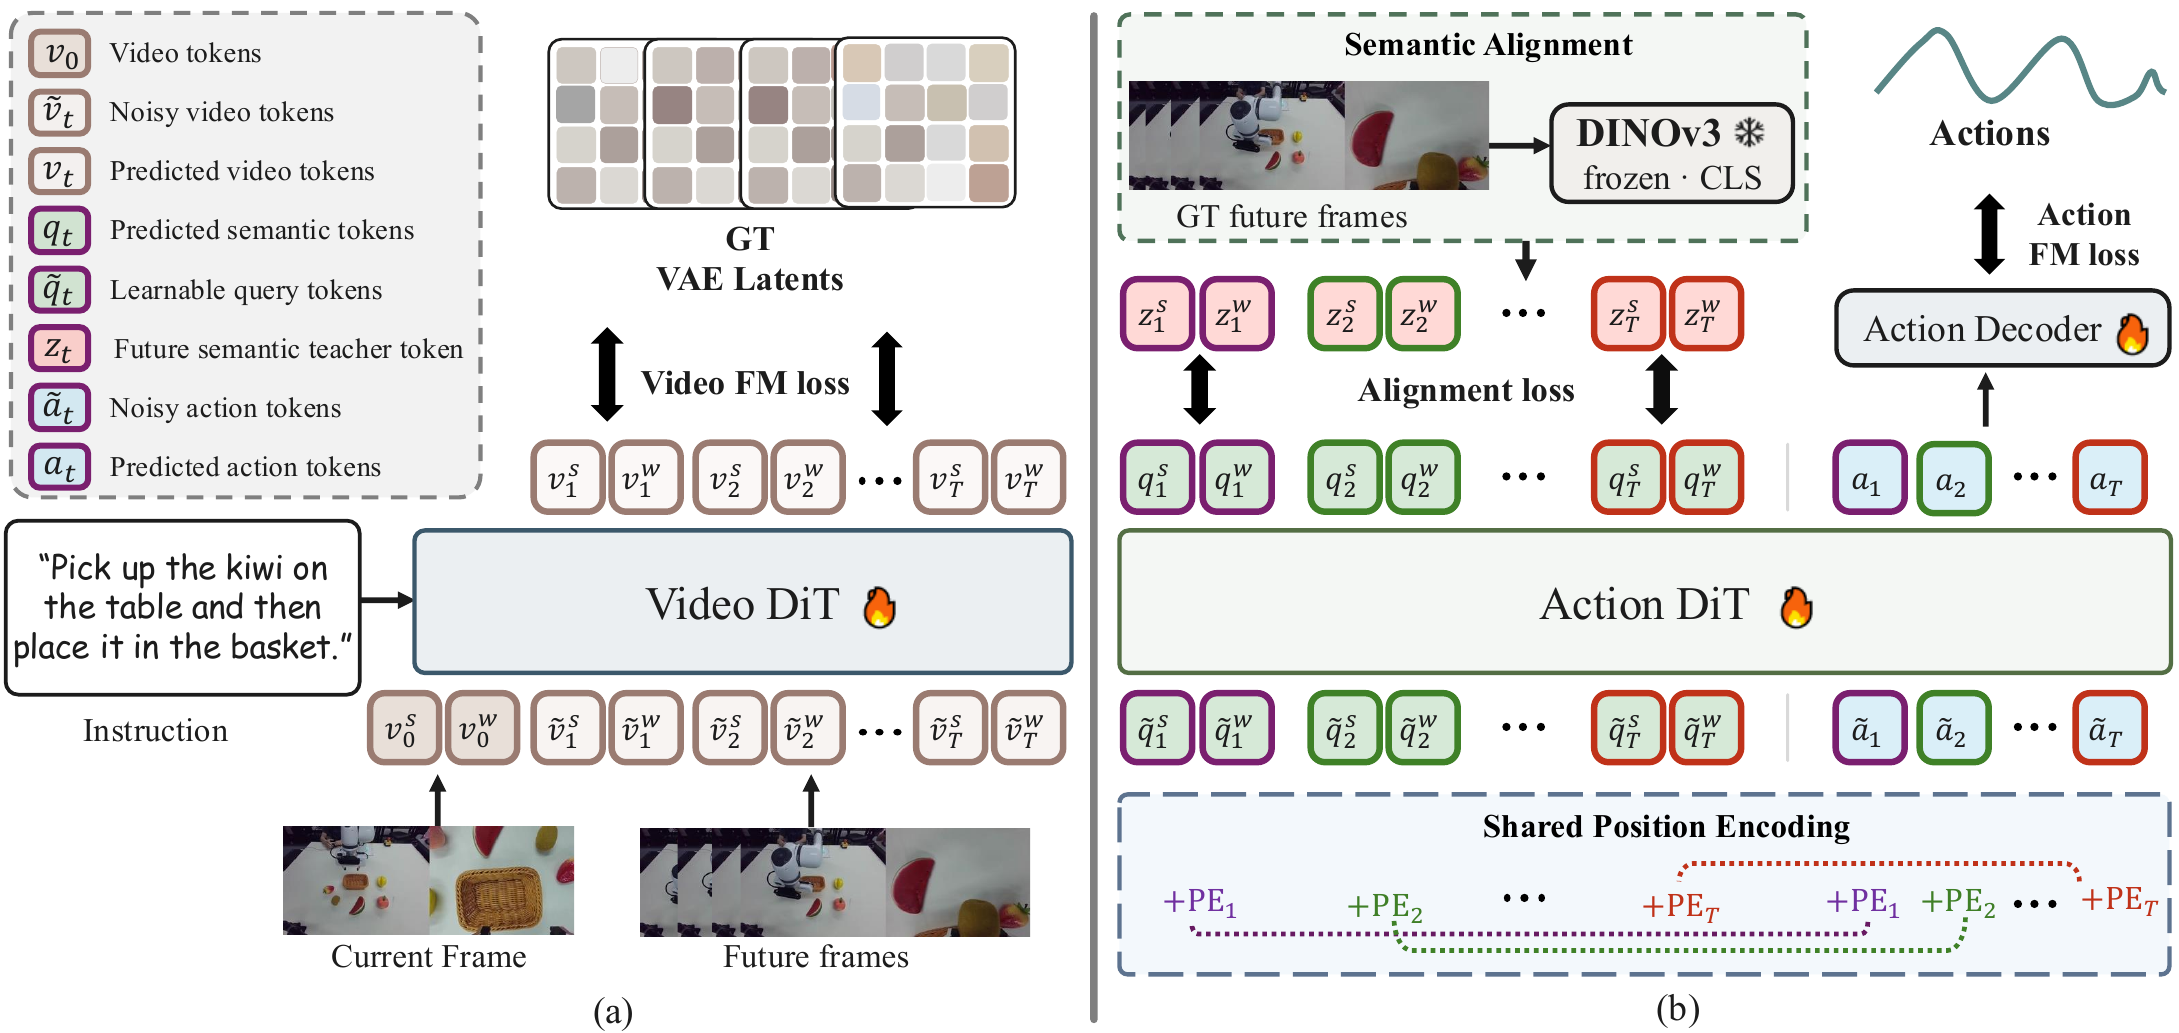
论文针对 VAE latent 重像素细节导致 WAM 在光照等视觉变化下动作不稳的问题。复现时保留预训练 WAM 的 VAE、video DiT 和 action DiT,在每个未来时间步和相机视角加入一个 learnable query token,并复用对应 action token 的 positional encoding;训练时用 frozen DINOv3 ViT-B/16 提取未来真值帧 CLS feature,经 linear head 将 query output 与其做 cosine alignment,原视频生成和动作预测 loss 保持不变。推理时移除 DINOv3 和 alignment head,只保留 query token。
方法已接入 GE-Act 和 FastWAM,也在 LingBot-VA 上评测。LIBERO-Plus、RoboTwin 随机扰动和真机未知光照均有改善;常规环境表现没有下降。新增参数约 0.016M,推理延迟约增加 4%。目前只发布 GE-Act checkpoint;FastWAM、LingBot-VA checkpoint 和真机部署指南尚未发布。
Transformer Transformer: A Unified Model for Motion-Conditioned Robot Co-design
[Gemini 3.1 Pro] 训练基于 RoboTokens 的扩散 Transformer,利用自身预测的动力学奖励梯度引导形态生成 | 👤 Stanford University, Huy Ha, Shuran Song | 🌐 | 📃 2607.25798 | ✨ | [📂]- |
为了解决特定任务的机器人形态设计问题,本文将机器人的物理结构和状态动作统一表示为 RoboTokens 并训练了一个扩散 Transformer。该模型通过掩码不同的 token 来同时学习形态生成和跨形态控制。在推理阶段,模型利用自身预测的完整动力学轨迹来计算奖励梯度,并用此梯度引导形态 token 的扩散去噪,从而生成针对目标轨迹优化的机器人设计。
实验发现增加推理时间的并行采样能提升设计质量,但计算收益会在一分钟左右遇到瓶颈。此外当前方法仅支持基于图元的几何体表示,尚未支持任意网格或可变形物体。
Explicit Kinematic Guidance from Analytic Concepts for Vision-Language-Action Models
[Gemini 3.1 Pro] 引入物理概念专家先提取 3D 信息再微调 VLA | 👤 SJTU, Mingyang Sun, Jianhua Sun | [🌐]- | 📃 2607.26513 | ✨ | [📂]-
现有 VLA 模型依赖 2D 输入导致缺乏 3D 物理空间感知,本文引入一个概念专家模块,先用视觉基础模型估计物体的运动和结构参数,随后在推理时动态跟踪这些参数以对齐观察,并在微调时作为空间引导和密集奖励训练 VLA。
实验显示该结构化引导能提高监督学习和强化学习操作成功率。
HiFi-UMI: Learning Deployable Manipulation Policies from High-Fidelity UMI Data Alone
[Gemini 3.1 Pro] 采集高保真数据以实现零真机数据的 VLA 部署 | 👤 Simple AI, Yuteng Wei, Xiaofei Li | [🌐]- | 📃 2607.25895 | ✨ | [📂]-
现用便携 UMI 采集的数据保真度低且需要混入真实机器人数据微调,本文设计了带头戴离线 SLAM 和 200 度双广角相机的微秒级同步采集系统,录制了两千小时数据,仅用这些数据后训的策略直接部署在真机上就能匹配同分布遥操的成功率。
A Causality-aware Infer-diagnose-refine Framework for Test-time Modality Adaptation in VLA Models
[Gemini 3.1 Pro] 测试时动态调整视觉输入权重来细化 VLA 动作 | 👤 Tsinghua, Haoyu Zhang, Fan Li | [🌐]- | 📃 2607.25516 | ✨ | [📂]-
机器人操作在不同阶段对视觉观察的依赖程度不同,本文提出推断-诊断-细化框架,先在正常和视觉掩码两种反事实情况下推断动作,借此量化视觉特征的因果权重,最后用门控残差网络在免训练下细化动作预测。
FELT: Generating Tactile Signals from Vision for Visuo-Tactile Manipulation
[Gemini 3.1 Pro] 从 RGB 图像生成双指不对称触觉特征辅助策略学习 | 👤 Tsinghua, Zinan Li, Daniel Seita | 🌐 | 📃 2607.20683 | ✨ | [📂]-
触觉传感器脆弱且收集数据困难,本文利用冻结的视觉编码器和轻量查询解码器,将左右面板分两支独立解码,直接从 RGB 图像单向生成双指的高保真触觉特征。
生成的特征在推理时无需实体传感器即可提升接触任务成功率。
WCM: A World Critic Model for Vision-Language-Action Reinforcement Learning
[Gemini 3.1 Pro] 评价器兼顾状态预测和奖励估计捕捉时间动态 | 👤 Fudan, Senyu Fei, Xipeng Qiu | [🌐]- | 📃 2607.29613 | ✨ | [📂]-
传统 VLA 强化学习的评价器单帧输入难以捕捉操作中的跨时间动态,本文将轻量级 LeJEPA 架构引入作为评价器 WCM,让其同时预测未来潜在状态和估计回报,从而解决状态近似不足的问题,并兼容 Pi0 和 OpenVLA 强化训练。
FA-RDP: A Frequency-Adaptive Reactive Diffusion Policy for Contact-Rich Manipulation
[GPT-5] 接触前保留多模态 diffusion 采样并在接触后切到单步高频力控 | 👤 上海交通大学, Lifeng Zhuo, Chuan Wen | 🌐 | 📃 2607.28596 | ✨ | 📂
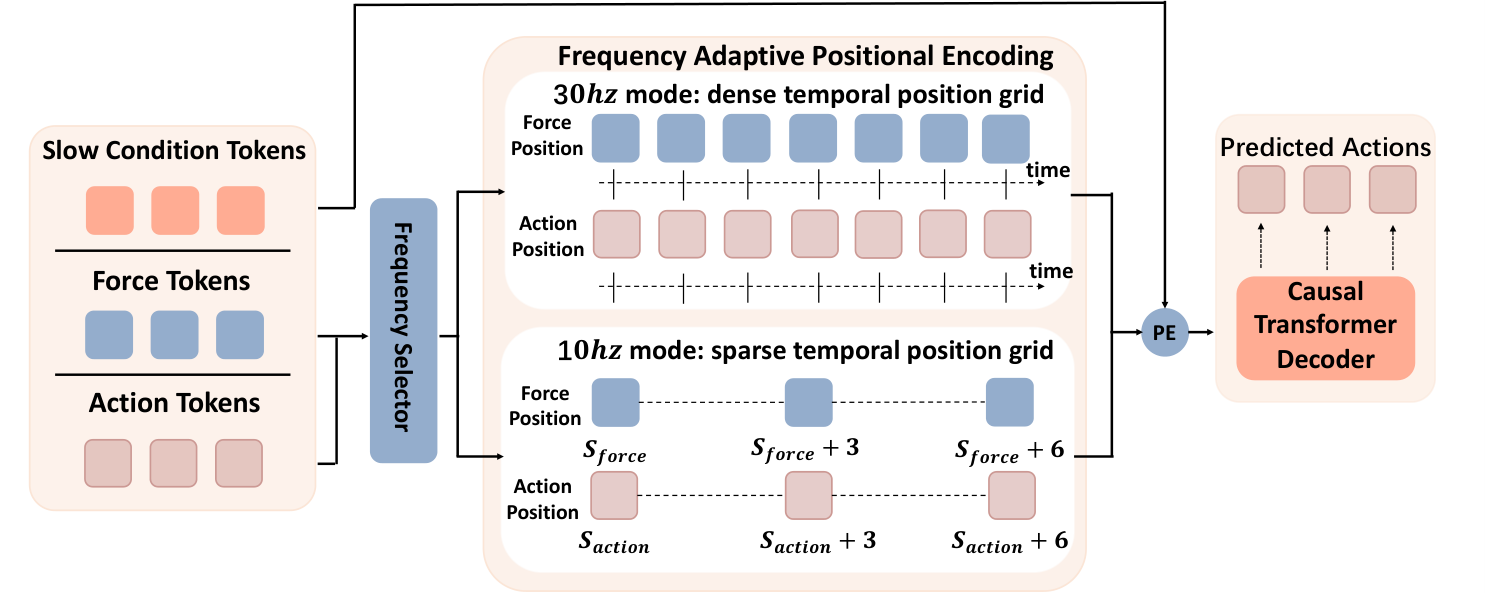
FA-RDP 用一个视觉和力 Transformer 同时预测 10 Hz 的 16 步 chunk 与 30 Hz 的 48 步 chunk,两者都覆盖 1.6 秒。接触前 indicator 检测到动作仍有多种可行路径时,使用低频多步 DDIM;接触后动作不确定性下降时,改用高频单步模型并每步刷新 force token。高频模型通过 MCD 直接预测 clean action chunk,再由 DDPM 公式换算噪声并保留原始残差监督。
indicator 的监督来自冻结低频策略对同一观测采样 8 次后的平均 action 误差,并非人工接触阶段标签。评测只有三项 Flexiv 真机任务,每项 60 条示范。
FA-RDP: A Frequency-Adaptive Reactive Diffusion Policy for Contact-Rich Manipulation
[Gemini 3.1 Pro] 接触任务中自适应切换扩散策略的推理频率 | 👤 SJTU, Lifeng Zhuo, Han Xue | [🌐]- | 📃 2607.28596 | ✨ | [📂]-
丰富接触任务在接触前需要低频多步采样以保持多模态,而接触后需要高频以反应反馈力,本文提出了频率自适应的反应式扩散策略,利用视觉-力混合 Transformer 根据接触状态动态预测高频和低频动作块。
Hybrid Impedance-Admittance Control with Multi-Link Aerial Robot for Contact-Rich Surface Sliding Task
[Gemini 3.1 Pro] 为多连杆空中机器人设计混合阻抗-导纳控制 | 👤 Tsinghua, Zicheng Luo, Jinjie Li | [🌐]- | 📃 2608.01800 | ✨ | [📂]-
为了解决多连杆空中机器人在表面滑动时的接触稳定性问题,本文结合阻抗控制和导纳控制策略,使机器人可以在自由飞行和表面交互模式之间灵活稳定切换。
The Gate, Not the Cache: Gate Provenance Bounds the Closed-Loop Reliability of Training-Free VLA Token Skipping
[Gemini 3.1 Pro] 指出决定免训练 Token 跳过机制可靠性的是门控信号来源 | 👤 UCB, Qi Luo, Hao Zhao | [🌐]- | 📃 2608.00391 | ✨ | [📂]-
为了在降低 VLA 推理延迟的同时保障控制可靠性,本文深入探究了免训练 Token 跳过机制的闭环表现,发现系统鲁棒性的关键边界由门控信号的计算来源和规律决定,而非缓存本身。
Event-Based Upper-Body Humanoid Teleoperation Under Challenging Illumination
[Gemini 3.1 Pro] 融合事件相机信息提升人形机器人在极端光照下的遥操表现 | 👤 NVIDIA, Haoyu Fu, Chengze Li | [🌐]- | 📃 2607.29227 | ✨ | [📂]-
面对传统视觉遥操在强光或逆光下容易跟丢的问题,本文引入事件相机捕捉高动态范围光照特征,融合 RGB 信息提取上半身运动学参数,在恶劣光照下也实现了稳定的人形机器人遥操作。
SM4RT: Learning Structured Motion Geometry for 4D Reconstruction
[Gemini 3.1 Pro] 将场景运动分解为 SE(3) 基重构 4D 运动几何 | 👤 Tsinghua, Yiming Yang, Li Yi | [🌐]- | 📃 2607.22534 | ✨ | [📂]-
本文提出结构化运动 4D 重构 Transformer,将密集的场景运动分解为由时间序列组成的 6D SE(3) 扭曲运动基,同物体的像素共享同一组刚体运动轨迹权重,从单目 RGB 视频直接端到端推断出 3D 几何和运动结构。
Temporal Policy: History-Initialized Action Generation for Robotic Learning from Demonstration
[Gemini 3.1 Pro] 从机器人历史状态初始化生成流匹配降低推理延迟 | 👤 NVIDIA, Dylan Miller, Martin Jagersand | 🌐 | 📃 2607.29482 | ✨ | 📂
生成式策略在示教学习中采样开销大,本文将动作生成建模为时间耦合传输问题,不从纯噪声而是从近期历史状态初始化流匹配过程,使得需要拟合的向量场更平直,从而大幅降低推理延迟并保持成功率。
When Does Legacy Data Start to Help? Emergent Transfer in Cross-Configuration Robot Learning
[Gemini 3.1 Pro] 研究跨硬件机器人学习中历史数据的有效阈值 | 👤 Tsinghua, Tao Wang, Yang Gao | [🌐]- | 📃 2607.25593 | ✨ | [📂]-
当机器人硬件升级后复用旧配置数据往往不会立刻见效,本文通过测试发现存在一个转换临界点,只有新配置数据积累到最低任务能力要求后,与旧数据联合训练才会产生收益并迎来成功率急速增长。
Ordered Action Tokens for Visuomotor Policy Learning
[Gemini 3.1 Pro] 按有序重要性量化连续动作为离散 Token 以灵活推理 | 👤 Tsinghua, Chaoqi Liu, Yilun Du | [🌐]- | 📃 2607.21670 | ✨ | [📂]-
现有的动作标记化方法缺乏结构性,本文设计了有序动作标记器 OAT,用 Transformer 将动作块离散为有序序列,前段 Token 包含粗略控制信息而后续 Token 补充残差细节,从而允许在推理时根据性能权衡灵活截断动作保真度。
Learning Panorama-Aware VLA for Mobile Manipulation with Whole-Body Teleoperation
[Gemini 3.1 Pro] 采集带移动底盘的全景数据训练具有全局空间感知的移动 VLA | 👤 Beihang, Donglin Yang, Si Liu | [🌐]- | 📃 2608.02257 | ✨ | [📂]-
移动操作需要底盘与机械臂协同以及全局空间理解,本文开发了一套基于单 VR 接口的全身遥操系统采集多模态数据集,并利用全景编码器融合局部观察与机器人状态输出联合动作,解决了传统局部视角容易丢失目标的问题。
FIRMGrasp: A Friction-Informed Risk Margin for Robust Grasp Synthesis
[Gemini 3.1 Pro] 考虑摩擦系数分布不确定性进行风险调整的抓取综合评价 | 👤 Boston University, Clinton Enwerem, Calin Belta | [🌐]- | 📃 2607.25049 | ✨ | [📂]-
经典抓取质量指标通常假设单一摩擦系数导致预测力闭合易失效,本文提出了基于条件风险价值的摩擦波动感知抓取指标 FIRMGrasp,它计算恶劣摩擦尾部分布折现后的力闭合裕度,从而准确筛选出被标称指标误判为高质量的高风险抓取。